La capacité annoncée ne correspond jamais entièrement à la mémoire disponible pour le modèle. Le système, les applications, le cache de contexte et, sur une architecture unifiée, la partie graphique utilisent la même réserve. Il faut donc raisonner en marge exploitable, pas seulement en taille de fichier.
Le choix en tableau
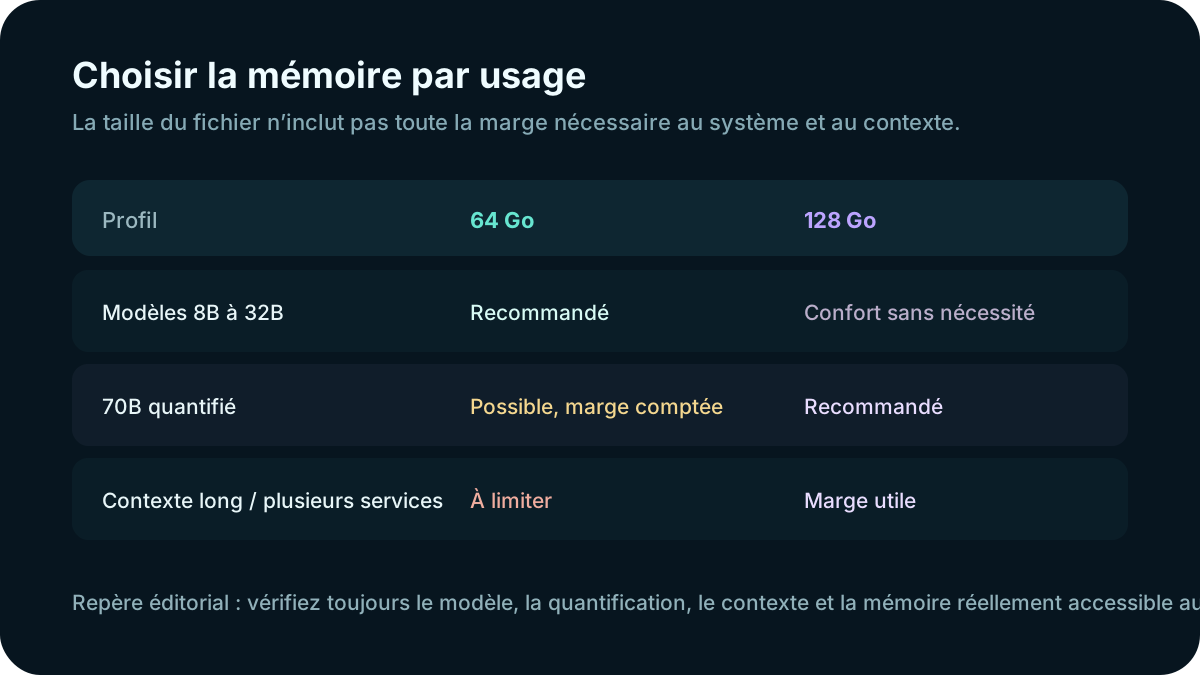
| Critère | 64 Go | 128 Go |
|---|---|---|
| Modèles 8B à 32B quantifiés | Très confortable | Confort identique, réserve largement inutilisée |
| Modèle 70B en Q4 | Possible avec une marge surveillée | Plus confortable pour le contexte et les services |
| Long contexte | À dimensionner avec soin | Marge nettement supérieure |
| Plusieurs modèles ou utilisateurs | Un gros modèle à la fois | Meilleur palier pour la concurrence |
| Budget et choix de machines | Offre plus large | Plus rare, souvent soudé sur les plateformes compactes |
| Profil conseillé | Usage personnel avancé | Laboratoire local, 70B régulier, services multiples |
Pour la majorité des utilisateurs, 64 Go constituent le meilleur équilibre. Passez à 128 Go si un modèle 70B, un grand contexte ou plusieurs services font réellement partie du programme. Acheter 128 Go pour exécuter uniquement des modèles 8B n’améliore pas automatiquement leur vitesse.
Voir la fiche des configurations recommandées pour Ollama
Ce que 64 Go permettent
Avec 64 Go, les modèles quantifiés de 8B, 14B ou 32B laissent généralement assez de place au système et à un contexte raisonnable. Ce palier permet de discuter, coder, résumer des documents ou utiliser une interface web sans gérer chaque gigaoctet. Il correspond bien à un mini-PC personnel qui n’exécute qu’un modèle principal à la fois.
Un modèle Llama 3.1 8B proposé par Ollama occupe environ 4,9 Go dans sa variante courante, alors que le 70B Q4_K_M atteint environ 43 Go. Ces nombres décrivent les fichiers du modèle, pas toute la mémoire à prévoir pendant l’inférence. Les tampons du moteur, le cache KV, le contexte et les autres processus s’ajoutent.
Le 70B quantifié peut donc entrer dans une machine de 64 Go, mais la marge devient un paramètre de fonctionnement. Une longue conversation, plusieurs requêtes parallèles ou une application lourde ouverte à côté peuvent provoquer un déchargement partiel vers le CPU, de la pagination ou un échec de chargement. Réduire le contexte ou choisir une quantification plus compacte rend alors davantage service qu’une optimisation cosmétique.
Pour découvrir l’IA locale, développer avec Ollama et conserver plusieurs modèles sur le SSD, 64 Go offrent déjà une base durable. Notre guide sur la RAM nécessaire à un LLM local explique aussi les paliers inférieurs si votre usage reste centré sur de petits modèles.
Quand 128 Go devient utile
Le passage à 128 Go devient rationnel quand la mémoire est la contrainte principale, pas quand le processeur ou le GPU est trop lent. Il permet d’accueillir un gros modèle quantifié avec plus de cache, de conserver une base vectorielle en mémoire ou d’héberger plusieurs services sans pousser immédiatement le système vers le fichier d’échange.
Sur un Ryzen AI Max+ 395, AMD annonce jusqu’à 128 Go de LPDDR5x unifiée et jusqu’à 96 Go configurables comme mémoire graphique. Cette capacité rend possibles des modèles qui dépassent la VRAM d’une GeForce grand public. Elle ne signifie pas que les 128 Go peuvent tous être donnés au moteur : Windows ou Linux et les autres applications doivent garder leur part.
Un grand contexte mérite une attention particulière. Ollama indique qu’augmenter la fenêtre de contexte accroît la mémoire requise et recommande au moins 64 000 tokens pour certains usages d’agents ou de code. Le cache augmente encore avec les requêtes parallèles. Dans ce scénario, les 64 Go supplémentaires ne servent pas à « rendre intelligent » le même modèle, mais à éviter un compromis constant entre contexte, concurrence et stabilité.
Le palier 128 Go intéresse aussi les utilisateurs qui testent plusieurs familles de modèles, génèrent des images localement ou font tourner une base documentaire en même temps. Il faut toutefois vérifier avant l’achat si la mémoire est soudée, quelle quantité peut être affectée au GPU et si le refroidissement maintient les performances sur une charge longue.
Modèle, contexte et cache
La bonne estimation commence par la quantification exacte. Deux modèles portant le même nom peuvent occuper des tailles très différentes en Q2, Q4, Q5 ou Q8. Une quantification plus lourde préserve davantage d’information, mais réclame plus de mémoire. Le nombre de paramètres seul ne donne donc pas la taille finale à charger.
Le contexte est la seconde variable. Chaque token conservé pour la conversation alimente un cache qui prend de la place en mémoire. Un modèle de 8B avec un contexte extrême peut consommer bien plus que son fichier. Inversement, un 70B utilisé avec un contexte court et une seule session peut rester compatible avec 64 Go.
La troisième variable est la concurrence. La FAQ d’Ollama précise que la mémoire nécessaire peut évoluer avec le nombre de traitements parallèles multiplié par la longueur de contexte. Un serveur utilisé par trois personnes n’a donc pas le même profil qu’une application personnelle, même si les deux chargent le même fichier.
Gardez enfin une réserve pour le système. Sur 64 Go, viser une occupation permanente proche de la limite rend la machine sensible à la moindre application supplémentaire. Sur 128 Go, la réserve est plus facile à conserver, mais elle doit tout de même être définie dans le BIOS ou les réglages graphiques lorsqu’une partie de la mémoire est partagée avec l’iGPU.
Unifiée ou extensible
Deux mini-PC de 64 Go peuvent se comporter très différemment. Sur une machine à mémoire unifiée, le CPU et le GPU accèdent à un même espace. Cette organisation permet à l’accélérateur d’utiliser une part importante de la mémoire système sans copier tout le modèle vers une VRAM séparée. Elle est particulièrement intéressante pour charger un modèle plus gros que la mémoire d’une carte dédiée moyenne.
Sur un mini-PC classique à barrettes SO-DIMM, la RAM peut souvent être remplacée, mais l’iGPU ne bénéficie pas toujours de la même bande passante ni de la même allocation. Ajouter de la capacité n’efface pas une bande passante limitée. La machine pourra charger le modèle, mais sa génération peut rester lente.
Une carte NVIDIA possède sa propre VRAM, beaucoup plus rapide, mais strictement limitée. Un modèle qui tient entièrement dans 16 ou 24 Go profite généralement mieux de l’accélération CUDA. Un modèle de plus de 40 Go devra être réparti entre GPU et mémoire système, ce qui modifie fortement les performances. C’est précisément le choix étudié dans notre comparatif Strix Halo ou PC NVIDIA.
La capacité et la bande passante répondent donc à deux problèmes différents. 128 Go augmentent les modèles et contextes possibles ; ils ne garantissent pas un débit supérieur. Avant d’acheter, demandez-vous d’abord si votre blocage prévisible sera de faire entrer le modèle ou de le faire générer plus vite.
Les erreurs de dimensionnement
La première erreur consiste à comparer uniquement la taille téléchargée à la RAM totale. Prévoyez le système, le cache et une marge. La seconde est de réserver presque toute la mémoire à l’iGPU : la machine peut alors devenir instable ou paginer dès qu’un navigateur et une base documentaire sont ouverts.
La troisième erreur est d’acheter 128 Go avec un processeur ou un backend qui n’exploitera pas correctement le GPU. La capacité autorise le chargement, mais une génération principalement sur CPU peut rester trop lente pour votre usage. Vérifiez le moteur, les pilotes et le partage CPU/GPU affiché par Ollama avec ollama ps.
Enfin, n’oubliez pas le stockage. Une bibliothèque composée de plusieurs quantifications d’un 70B occupe rapidement des centaines de gigaoctets. Une machine de 128 Go équipée d’un SSD de 512 Go sera vite plus contraignante qu’un modèle 64 Go accompagné d’un SSD de 2 To.
Quel palier choisir
Choisissez 64 Go pour les modèles 8B à 32B, le développement personnel, le RAG local et un 70B utilisé ponctuellement avec une quantification compacte. Ce palier laisse davantage de choix de mini-PC et préserve le budget pour un meilleur SSD ou un refroidissement plus sérieux.
Choisissez 128 Go si le 70B est votre modèle quotidien, si vous avez besoin de longs contextes, si plusieurs utilisateurs interrogent le serveur ou si des applications d’image et de texte doivent cohabiter. Sur Strix Halo, contrôlez la quantité réellement affectable au GPU et la mémoire laissée au système.
Ne choisissez aucun des deux à l’aveugle si vous ignorez encore le modèle cible. Installez d’abord Ollama sur une machine disponible, observez la taille et le contexte nécessaires, puis extrapolez. Le modèle, sa quantification et le nombre de sessions fournissent une base d’achat beaucoup plus solide qu’une étiquette « PC IA ».
Notre préférence éditoriale va donc à 64 Go comme configuration polyvalente et à 128 Go comme choix spécialisé. Le second palier est excellent quand sa marge sera utilisée ; il reste superflu si l’objectif se limite à un petit assistant local.
Reprendre le choix complet du mini-PC, du modèle au stockage
Sources
Les repères ont été vérifiés le 24 août 2026 à partir des tailles publiées dans la bibliothèque Ollama, de la documentation sur la longueur de contexte et des spécifications du Ryzen AI Max+ 395. Les besoins réels varient selon le modèle, la quantification et le moteur.