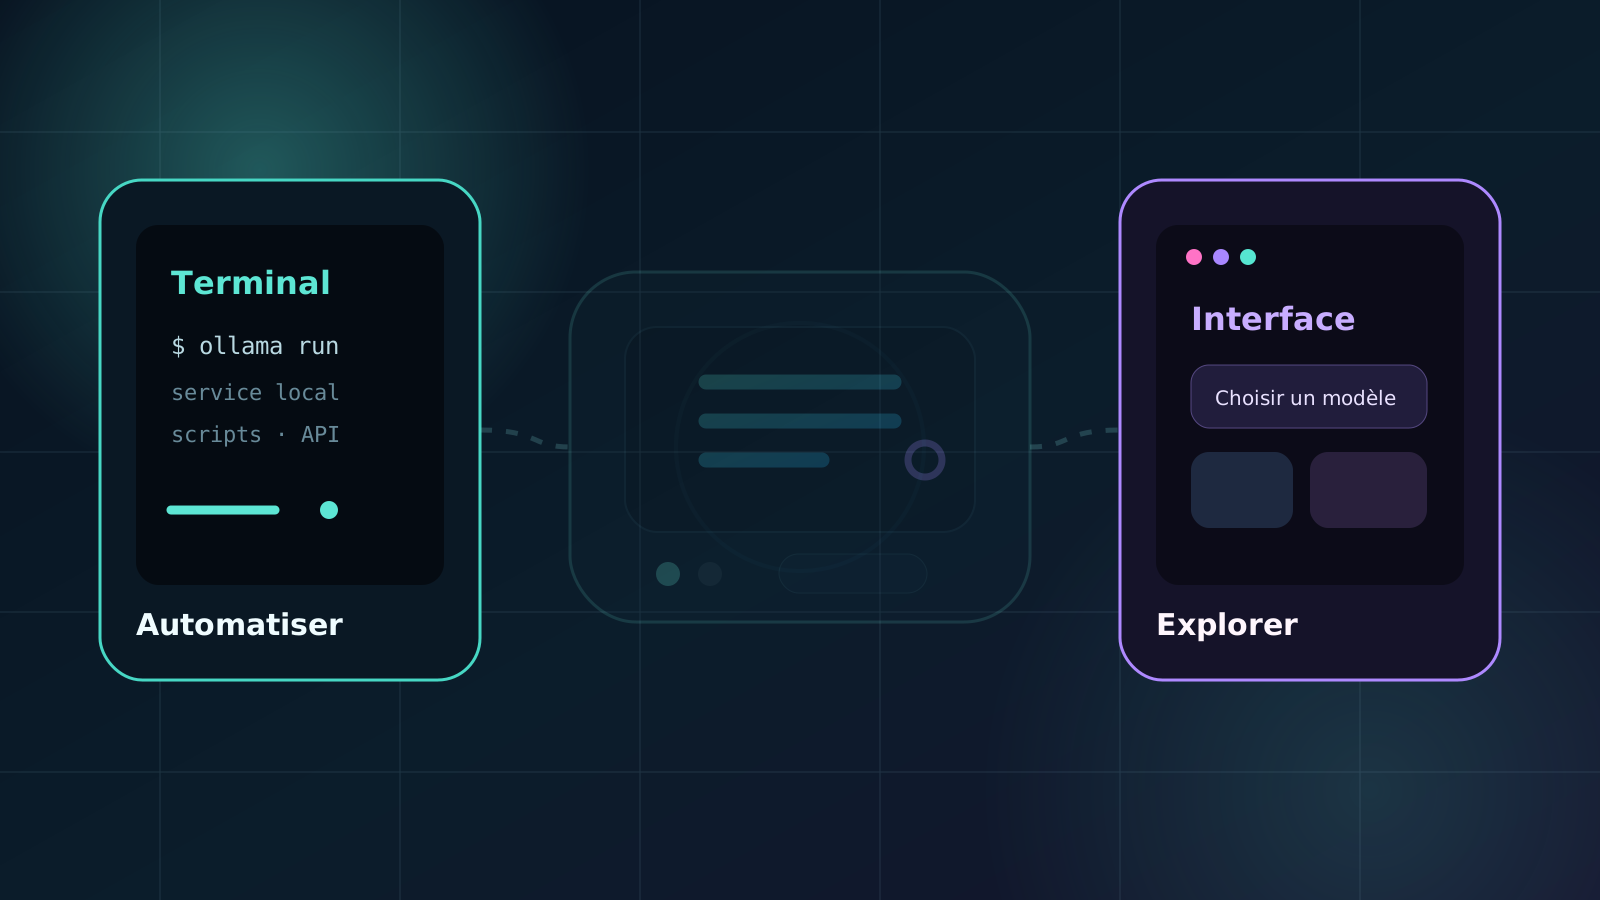
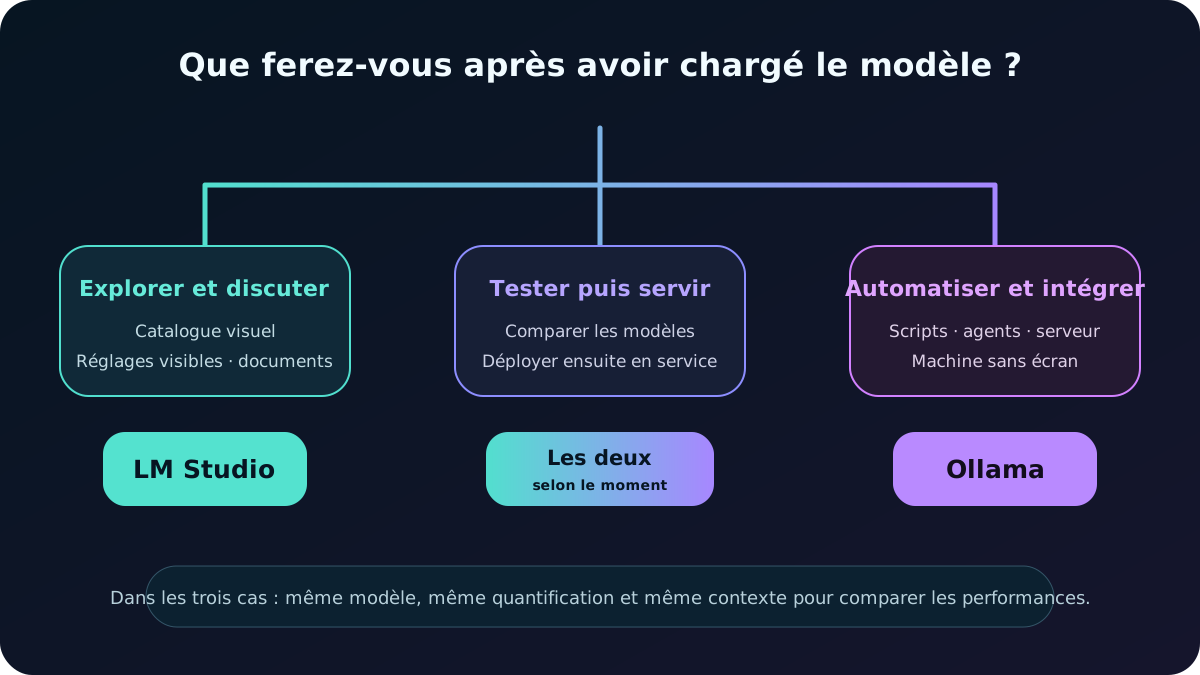
La différence la plus utile ne se résume plus à « interface graphique contre terminal ». LM Studio sait aussi fonctionner comme serveur et Ollama dispose désormais d’une application de bureau. Le choix dépend surtout de ce que vous ferez une fois le modèle chargé.
Le choix en un tableau
| Critère | Ollama | LM Studio |
|---|---|---|
| Prise en main | Commandes courtes, service local et application de bureau | Interface graphique centrée sur la recherche, le chat et les réglages |
| Usage naturel | Scripts, agents, éditeurs de code et serveur permanent | Découverte des modèles, essais et conversations avec des documents |
| Accès depuis un logiciel | Service HTTP local, port 11434 par défaut | Serveur local compatible avec des clients courants |
| Formats et moteurs | Bibliothèque Ollama, import de modèles et réglages par Modelfile | GGUF via llama.cpp et modèles MLX sur Apple Silicon |
| Machine sans écran | Très adapté à un service lancé au démarrage | Possible avec le composant llmster et la commande lms |
| Réglages visibles | Variables, commandes et fichier de modèle | Contrôles graphiques puis préréglages enregistrables |
Choisissez LM Studio pour parcourir des modèles, observer les paramètres et démarrer sans terminal. Choisissez Ollama pour alimenter un agent, un outil de code ou un serveur discret. Installer les deux reste pertinent si vous séparez expérimentation et service permanent.
Voir la fiche pour choisir le mini-PC adapté à votre modèle
LM Studio pour explorer
LM Studio rassemble dans une même application la recherche de modèles, leur téléchargement, leur chargement et une interface de conversation. Cette continuité évite de jongler entre un catalogue web, un terminal et un client de chat. Sur un premier mini-PC, elle permet surtout de voir immédiatement la taille du fichier, la quantification disponible et les réglages de chargement.
L’application sait exécuter des modèles GGUF avec llama.cpp sur macOS, Windows et Linux. Sur un Mac Apple Silicon, elle peut également charger des modèles au format MLX. Cette possibilité ne rend pas automatiquement chaque modèle plus rapide : il faut qu’une version MLX existe et comparer dans des conditions identiques. Elle offre néanmoins une seconde voie d’exécution utile sur les puces Apple.
Le chat avec des documents est intégré. Pour découvrir le RAG local, résumer quelques fichiers ou évaluer un modèle avec ses propres textes, ce parcours demande moins d’assemblage. Cela ne dispense pas de vérifier ce que l’application indexe, où les fichiers sont stockés et si le serveur est limité à la machine locale.
LM Studio n’est plus limité à sa fenêtre graphique. Sa documentation présente un serveur local, des bibliothèques Python et TypeScript, ainsi qu’un composant nommé llmster capable de fonctionner sans l’interface. L’écart avec Ollama s’est donc réduit. LM Studio garde toutefois son avantage lorsque la priorité est de voir, choisir et ajuster avant d’automatiser.
Ollama pour automatiser
Ollama est particulièrement à l’aise lorsqu’un modèle doit devenir un service de fond. Une commande télécharge et lance un modèle, tandis que le serveur local expose ses fonctions aux applications installées sur la machine. Après l’installation, le service écoute sur le port local 11434 par défaut. Les bibliothèques officielles Python et JavaScript facilitent ensuite l’intégration dans un projet.
Ce fonctionnement convient à un mini-PC placé dans un bureau, un atelier ou une baie domestique. L’utilisateur n’a pas besoin de garder une fenêtre ouverte pour discuter directement avec le modèle : un éditeur de code, une interface web ou un programme maison envoie les requêtes au service. Le démarrage automatique et la configuration par variables d’environnement s’intègrent bien à une machine Linux administrée à distance.
Le Modelfile permet de décrire un modèle de base, ses paramètres et ses instructions initiales. C’est utile pour reproduire une configuration sur une autre machine ou conserver plusieurs comportements à partir du même poids. Cette approche est moins visuelle que les préréglages d’une application, mais elle s’adapte mieux à un dépôt de configuration et à des déploiements répétés.
Ollama n’interdit pas une interface graphique. De nombreuses applications se connectent à son service et son application officielle couvre aussi les usages simples. Son point fort reste la capacité à disparaître derrière le travail quotidien. Pour installer correctement le service et déplacer le stockage des modèles, consultez notre guide d’installation d’Ollama sur mini-PC.
Les performances sur mini-PC
Il serait trompeur de déclarer un vainqueur en tokens par seconde sans préciser la machine et les réglages. Deux essais ne sont comparables qu’avec le même modèle, la même quantification, la même longueur de contexte, le même nombre de couches chargées sur l’accélérateur et une température stabilisée. Une interface différente peut aussi sélectionner un autre moteur ou d’autres valeurs par défaut.
Sur un mini-PC Windows équipé d’un GPU intégré AMD ou Intel, le backend réellement utilisé est déterminant. Une application capable de sélectionner facilement Vulkan peut exploiter l’iGPU alors qu’une configuration différente retombera sur le CPU. Sur Linux, la version des pilotes et la prise en charge de ROCm ou Vulkan changent également le résultat. Sur Apple Silicon, Metal et MLX constituent deux chemins possibles selon l’outil et le modèle.
La mémoire demeure le premier filtre. Si le modèle, son cache de contexte et le système dépassent la mémoire disponible, changer d’application ne corrigera pas le problème. Une quantification plus compacte ou un contexte réduit produira souvent un gain plus important qu’un changement d’interface. Notre guide sur la mémoire nécessaire à un LLM local fournit les repères avant de télécharger des dizaines de gigaoctets.
Pour choisir entre Ollama et LM Studio sur votre propre machine, chargez un modèle identique et mesurez au minimum le temps avant le premier token, le débit de génération, la mémoire consommée et la stabilité sur plusieurs réponses. Notez le moteur et les paramètres. Un résultat isolé, obtenu avec un modèle différent dans chaque outil, ne permet aucune conclusion sérieuse.
Confidentialité et réseau
« Local » décrit le lieu de l’inférence, pas une garantie globale. Ollama indique que les requêtes et réponses d’un modèle exécuté localement ne sont pas renvoyées à son service. Il propose aussi un mode local uniquement pour désactiver ses fonctions cloud. LM Studio permet de travailler hors ligne avec des modèles déjà téléchargés et de discuter avec des documents sur la machine.
Le risque apparaît surtout lorsque le serveur quitte localhost. Ollama écoute par défaut sur 127.0.0.1:11434. Modifier cette adresse pour accepter le réseau local rend le service accessible à d’autres appareils et impose des règles de pare-feu, une authentification adaptée et un proxy correctement configuré. Le même principe vaut pour le serveur de LM Studio.
Ne publiez jamais directement le port du moteur sur Internet. Un modèle local peut recevoir des documents sensibles, des extraits de code ou des historiques de conversation. Placez l’accès derrière une couche qui identifie les utilisateurs, limite les requêtes et conserve seulement les journaux réellement nécessaires. Pour un usage strictement personnel, garder l’écoute sur la boucle locale reste le choix le plus simple.
Utiliser les deux ensemble
Installer les deux outils n’est pas un aveu d’indécision. LM Studio peut servir de banc d’exploration : comparer plusieurs quantifications, observer la mémoire demandée et vérifier le comportement d’un modèle. Une fois le choix stabilisé, Ollama peut prendre le relais comme service permanent pour une interface web, un agent de code ou une automatisation.
Cette organisation évite toutefois de dupliquer inutilement les fichiers. Les catalogues et répertoires ne partagent pas toujours les mêmes chemins ou métadonnées. Sur un SSD de 1 To, quelques modèles de 20 à 50 Go et leurs variantes remplissent rapidement l’espace. Gardez seulement les versions utiles et documentez leur origine, leur licence et leur quantification.
La mémoire demande la même discipline. Fermez ou déchargez le modèle dans le premier outil avant d’en charger un autre. Sur une machine de 32 ou 64 Go, deux moteurs actifs peuvent pousser le système vers le fichier d’échange et donner l’impression que le matériel est lent. Le problème vient alors de la concurrence entre processus, pas du modèle lui-même.
Quel outil pour votre profil
Pour une première découverte, LM Studio offre le parcours le plus lisible. Le catalogue intégré, les réglages visibles et le chat permettent de comprendre ce que la machine peut charger avant de bâtir une installation plus complexe.
Pour le développement et les agents, Ollama reste le choix direct. Il se lance comme un service, se pilote facilement et s’intègre à de nombreux outils. Un mini-PC sans écran peut ainsi fournir un modèle à plusieurs logiciels du réseau privé, sous réserve d’une protection correcte.
Pour un Mac Apple Silicon, essayez les deux avec le même modèle lorsque GGUF et MLX sont disponibles. LM Studio donne accès aux deux familles de runtimes, tandis qu’Ollama conserve une intégration très pratique pour les scripts. La meilleure combinaison dépend davantage du modèle précis que du logo de l’application.
Pour un mini-PC Windows à GPU intégré, commencez par l’outil qui confirme clairement l’utilisation du GPU. Vérifiez le backend et la mémoire allouée au lieu de vous fier au pourcentage CPU affiché. Si l’accélération n’est pas active, le débit peut être très différent malgré une puce récente.
Le verdict tient donc en une phrase : LM Studio facilite l’exploration, Ollama facilite l’intégration. Avant d’acheter une machine, partez du modèle, de la mémoire et du backend comme l’explique notre guide pour choisir un mini-PC d’IA locale.
Voir la fiche mémoire avant de télécharger un grand modèle
Sources
Les fonctions décrites ont été contrôlées le 24 août 2026 dans la documentation du service local Ollama, la documentation de l’application LM Studio et la documentation technique LM Studio. Les versions, backends et compatibilités matérielles évoluent rapidement.