Que signifie un NPU de 50 TOPS ?
Un NPU est un processeur spécialisé dans certains calculs d’intelligence artificielle. TOPS signifie « milliers de milliards d’opérations par seconde ». Un NPU annoncé à 50 TOPS peut donc atteindre théoriquement 50 000 milliards d’opérations par seconde, dans les conditions retenues par son fabricant.
Ce chiffre n’est ni une quantité de mémoire ni un nombre de réponses générées par seconde. La précision du calcul compte : une mesure en INT8 ne se compare pas directement à une mesure en FP16. Le modèle, les opérations prises en charge et les transferts de données déterminent ensuite la part de cette capacité réellement utilisée.
Pour comparer deux NPU, cherchez une mesure obtenue avec la même précision et le même protocole. Sans ces indications, « 50 TOPS contre 40 TOPS » décrit une différence de débit théorique annoncé, pas une avance de 25 % dans votre application.
40 TOPS et le seuil Copilot+
Microsoft retient un NPU d’au moins 40 TOPS parmi les exigences des PC Copilot+. Il s’agit bien du NPU : un total additionnant plusieurs moteurs de calcul ne remplace pas ce seuil. Le processeur seul ne suffit pas non plus à établir que toutes les fonctions Copilot+ seront disponibles ; la configuration et les exigences logicielles doivent correspondre.
Ce seuil ne constitue pas une condition générale pour faire de l’IA locale. Un ordinateur sans NPU peut exécuter des modèles sur CPU ou GPU. À l’inverse, dépasser 40 TOPS ne garantit ni la compatibilité avec un modèle téléchargé ni sa vitesse de génération. L’intérêt du NPU dépend d’abord du logiciel que vous utiliserez.
MINIX : 50 TOPS ou 80 TOPS ?
Le Ryzen AI 9 HX 370 du MINIX ER937-AI illustre cette distinction. AMD annonce jusqu’à 50 TOPS pour son NPU et jusqu’à 80 TOPS au total. Présenter cette machine comme un « NPU de 80 TOPS » confondrait deux périmètres de mesure.
| Chiffre annoncé | Ce qu’il décrit | Ce qu’il ne garantit pas |
|---|---|---|
| 50 TOPS NPU | Le maximum théorique du moteur Ryzen AI | La compatibilité de chaque logiciel avec ce NPU |
| 80 TOPS au total | La capacité IA globale annoncée du processeur | 80 TOPS disponibles sur le NPU seul |
| 32 Go de RAM | La mémoire installée dans cette variante | 32 Go entièrement libres pour le modèle |
La variante étudiée associe ce processeur à une Radeon 890M, 32 Go de RAM et un SSD de 1 To. Ces caractéristiques répondent à des questions différentes : où s’exécute le calcul, quelle quantité de mémoire reste disponible et quels fichiers peut-on stocker ? Le total en TOPS ne permet pas de les remplacer par une seule note.
Pour examiner cette configuration concrète, consultez la fiche produit du MINIX ER937-AI 32 Go / 1 To, avec ses possibilités d’évolution et ses limites.
Quels logiciels utilisent le NPU ?
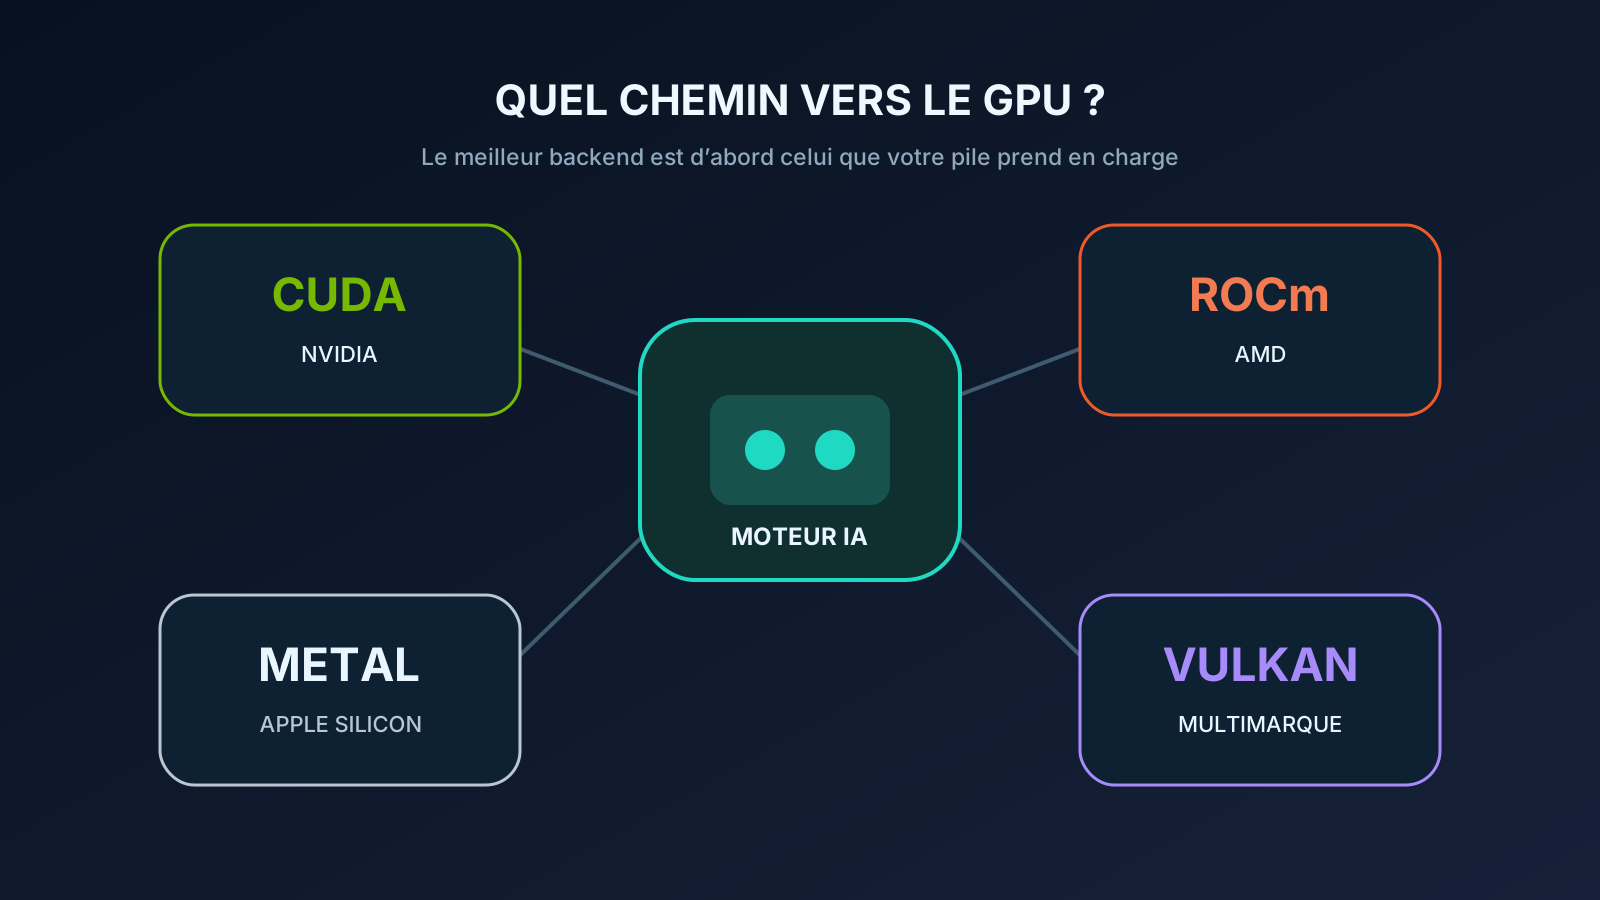
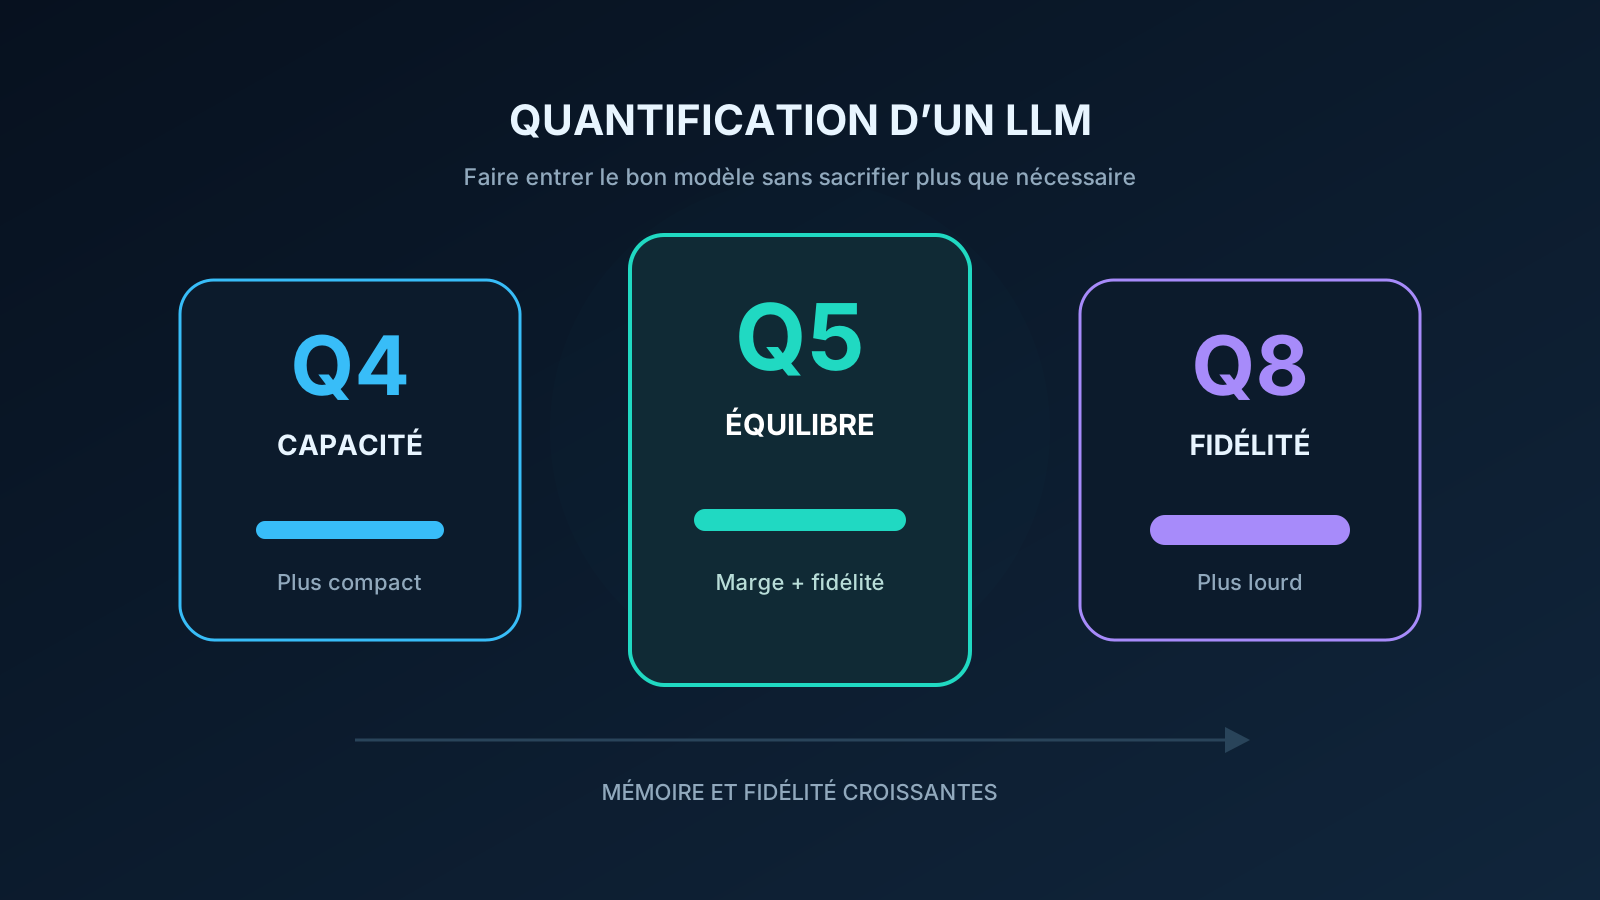
Une application doit disposer d’un chemin logiciel compatible pour envoyer ses calculs au NPU. Installer un modèle ou activer une option « IA » ne suffit pas. Le format du modèle, sa quantification, les pilotes et le moteur d’exécution doivent convenir au matériel.
Les LLM sur NPU existent déjà. La documentation Ryzen AI Software d’AMD décrit, pour les Ryzen AI 300 notamment, des modes NPU seul et hybrides NPU + GPU intégré via ONNX Runtime GenAI. Ces parcours concernent des modèles et configurations pris en charge : ils ne rendent pas n’importe quel fichier GGUF automatiquement compatible.
Ollama est un autre parcours logiciel. Sa documentation matérielle consultée décrit des accélérations GPU et ne promet pas l’utilisation automatique du NPU. Une machine équipée d’un NPU de 50 TOPS peut donc exécuter votre modèle sur un autre moteur. Avant l’achat, vérifiez la documentation de la version visée, pour votre système et votre processeur.

La mémoire limite les LLM
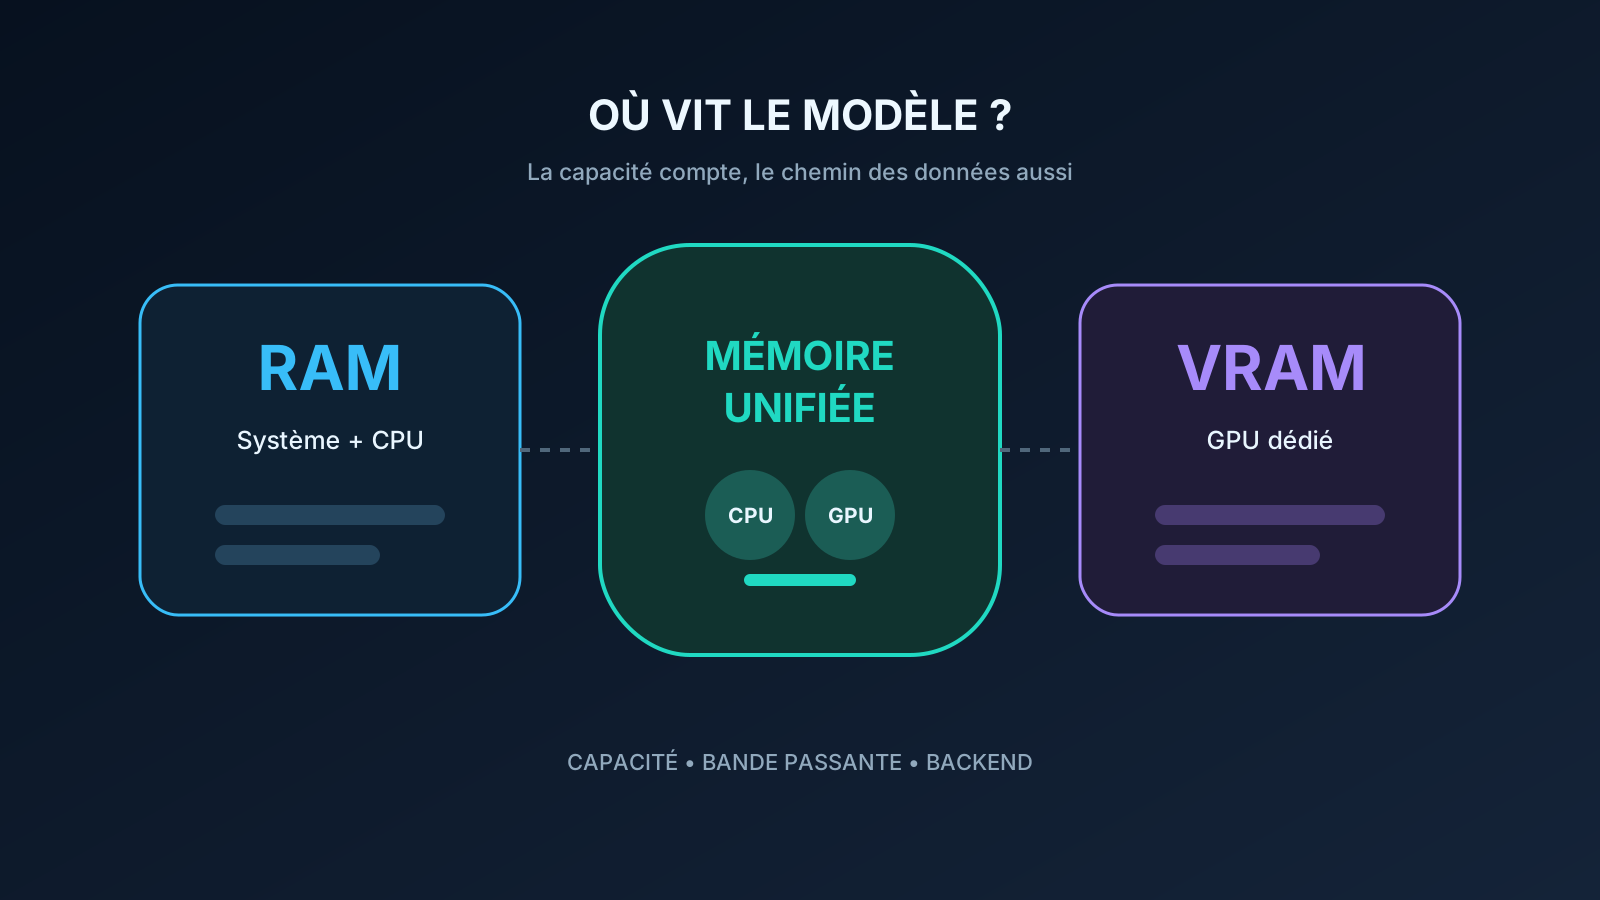
Un modèle de langage doit charger ses poids et conserver des données liées au contexte de la conversation. Le système et les autres applications utilisent aussi de la mémoire. Un chiffre élevé en TOPS ne crée donc pas la place nécessaire pour un modèle trop volumineux.
Sur une configuration de 32 Go, il faut raisonner avec le modèle exact, sa quantification et la longueur de contexte prévue. Un fichier qui tient sur le SSD ne tient pas nécessairement dans la mémoire accessible au moteur de calcul. Notre guide RAM, VRAM et mémoire unifiée explique ces différences avant de choisir une capacité.
Comparer avant de choisir
Partez d’une tâche précise : transcription, traitement d’image ou conversation avec un LLM. Identifiez ensuite le logiciel et le modèle qui l’exécuteront. Si leur documentation cite votre NPU et fournit une procédure compatible, ses caractéristiques deviennent utiles pour départager les machines.
Pour Ollama, commencez par la mémoire et le moteur matériel réellement pris en charge. Le guide choisir une configuration pour Ollama permet de poursuivre cette vérification. Le MINIX sert ici d’exemple pour comprendre les chiffres ; son NPU ne suffit pas à en faire le meilleur achat pour tous les usages.
Si vous comparez des tests, gardez le même modèle, la même quantification, le même contexte et la même tâche. Distinguez le délai avant la première réponse du débit de génération. Notez aussi la mémoire utilisée et la consommation lorsque le protocole les mesure. L’activité du NPU dans le gestionnaire de tâches confirme une utilisation, mais ne démontre pas à elle seule un gain de vitesse ou d’énergie.
Sources et compatibilités à vérifier
Les spécifications AMD et les modes d’exécution Ryzen AI sont cités près des explications concernées. Pour contrôler les autres points avant un achat ou une installation :
- Microsoft : rôle du NPU et exigences Copilot+.
- Ollama : matériel et accélérations GPU pris en charge.
- MINIX : caractéristiques de l’ER937-AI.