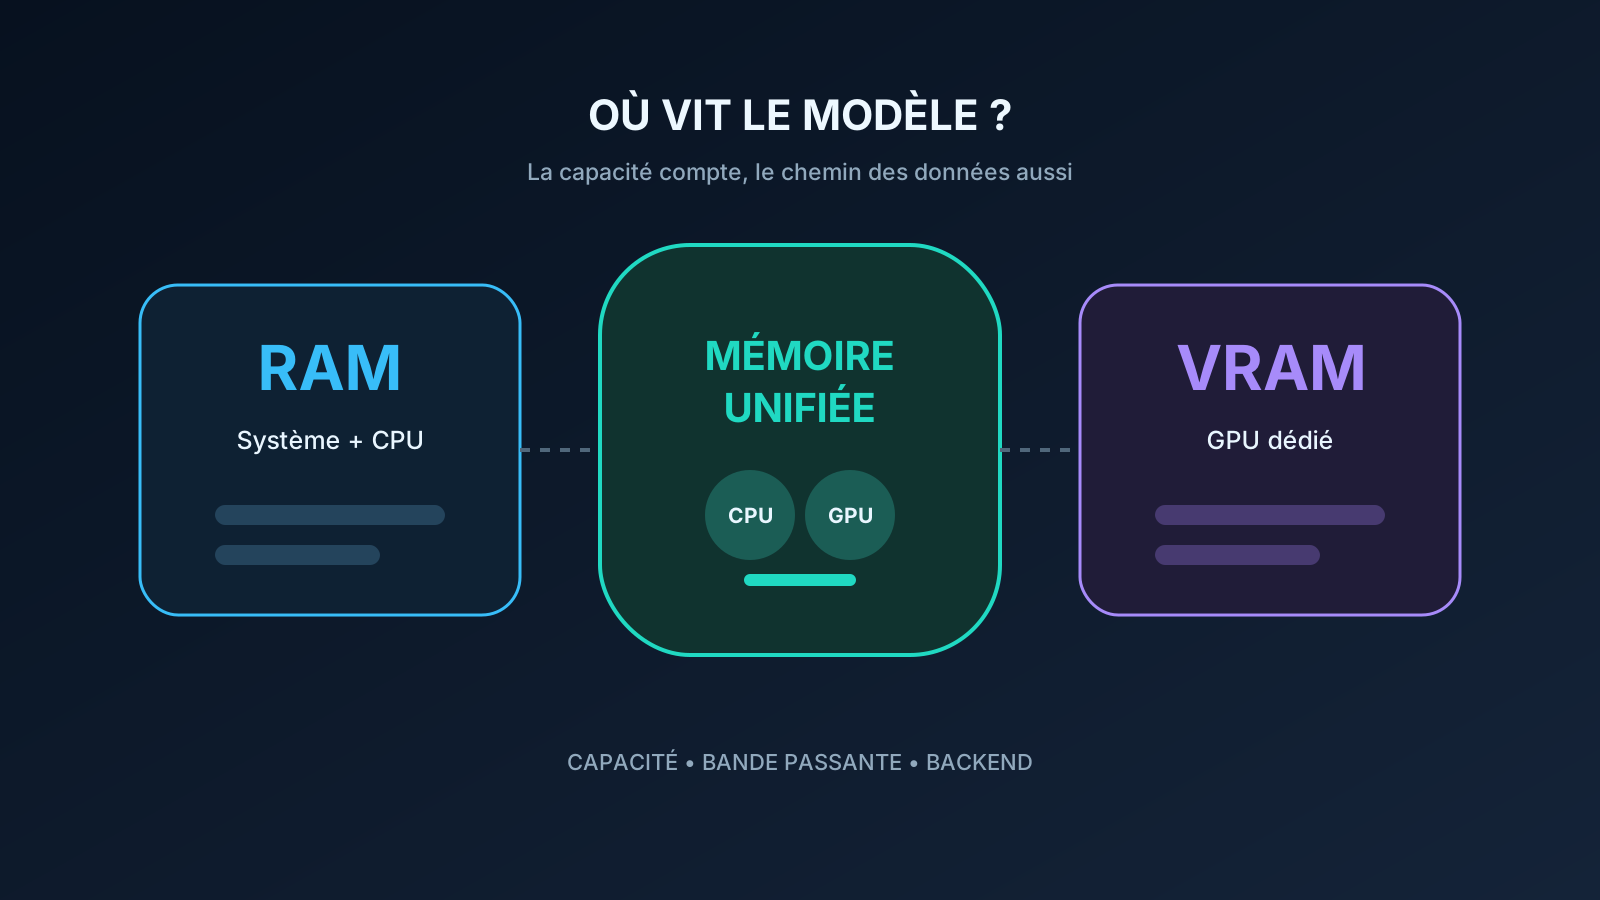
La RAM sert d’abord au système et au CPU, la VRAM appartient au GPU dédié, tandis qu’une mémoire unifiée forme une réserve partagée. Pour l’IA locale, le plus grand nombre ne suffit pas : bande passante, allocation et backend décident aussi du résultat.
Les différences en tableau
| Mémoire | Qui l’utilise ? | Atout pour un LLM | Contrainte |
|---|---|---|---|
| RAM | Système et CPU | Grande capacité, souvent extensible | Accélération CPU plus lente qu’un GPU adapté |
| VRAM | GPU dédié | Très forte bande passante, calcul accéléré | Capacité fixe et séparée |
| Mémoire unifiée | CPU et GPU intégrés | Grande réserve accessible sans VRAM séparée | Partagée avec le système, débit variable |
Le principe clé : la capacité indique si le modèle peut être chargé ; la bande passante et le backend indiquent surtout à quelle vitesse il travaillera. Une machine capable d’ouvrir un 70B n’est pas forcément la plus rapide sur un 8B.
Voir la fiche de choix entre 64 Go et 128 Go
La RAM côté système
La RAM héberge Windows ou Linux, les applications, les données du modèle exécuté sur CPU et une partie des tampons du moteur. Sur un mini-PC classique, elle prend souvent la forme de barrettes SO-DIMM remplaçables. Cette évolutivité permet de commencer avec 32 Go puis de passer à 64 Go, à condition que la carte mère et le processeur acceptent cette capacité.
Un LLM peut fonctionner entièrement en RAM avec le CPU. C’est compatible avec beaucoup de machines, mais le débit dépend fortement de la bande passante mémoire, du nombre de cœurs et des optimisations du moteur. Ajouter de la RAM règle un manque de capacité ; cela ne transforme pas une puce modeste en accélérateur haut de gamme.
La capacité annoncée n’est jamais intégralement disponible. Le système, le navigateur, l’interface de chat, une base vectorielle et le cache de contexte occupent leur part. Sur 32 Go, un modèle de 28 Go ne dispose donc pas d’une marge saine. La pagination vers le SSD peut provoquer de longs blocages au lieu d’un simple ralentissement régulier.
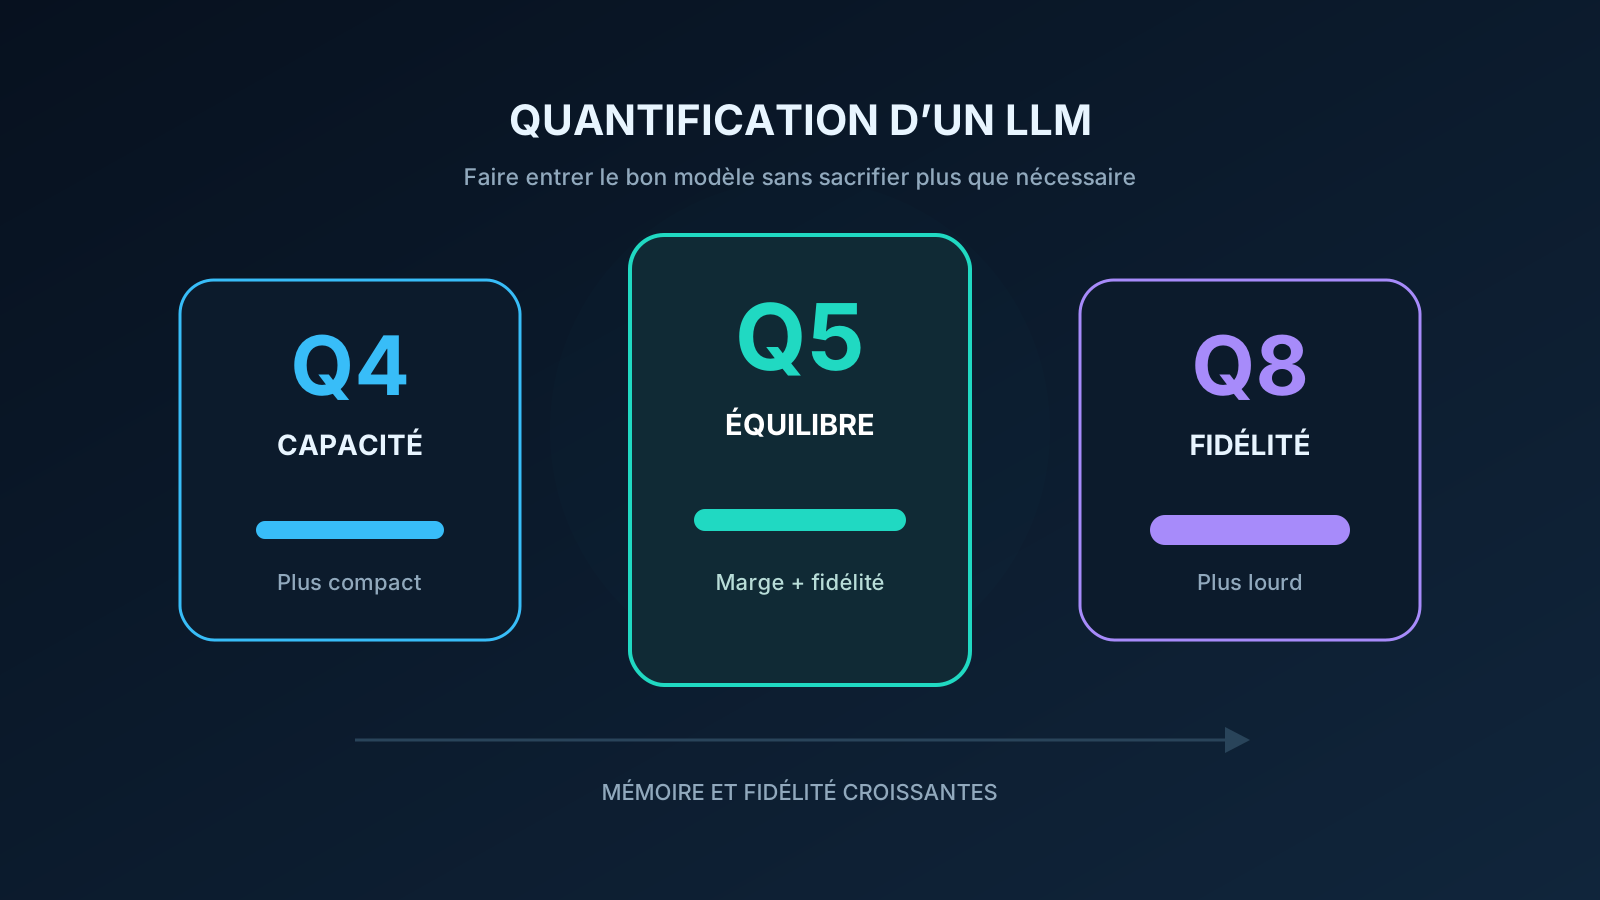
Pour dimensionner la RAM, partez de la taille réelle de la quantification, ajoutez le cache lié au contexte et conservez une réserve système. Notre guide sur la quantification Q4, Q5 et Q8 explique pourquoi deux variantes du même modèle changent complètement ce calcul.
La VRAM côté GPU
Une carte graphique dédiée possède sa propre mémoire, reliée par un bus très rapide au GPU. Lorsque le modèle et son cache tiennent en VRAM, les couches restent près des unités de calcul et l’inférence évite de fréquents transferts avec la RAM. C’est l’une des raisons pour lesquelles une carte NVIDIA correctement prise en charge donne souvent un excellent débit.
La limite est rigide. Une GeForce équipée de 16, 24 ou 32 Go ne peut pas emprunter librement toute la RAM comme si elle devenait de la VRAM identique. Le moteur peut répartir des couches entre GPU et CPU, mais les échanges sur le bus et le calcul côté processeur réduisent alors les performances.
La VRAM ne doit pas être comparée seulement par capacité. Sa bande passante, la génération du GPU, les formats de calcul et le logiciel comptent. Une carte de 16 Go récente peut exécuter très vite un modèle qui tient, tandis qu’une réserve unifiée de 64 Go peut charger plus gros mais générer moins rapidement.
Ce contraste est au cœur de notre comparaison entre mini-PC Strix Halo et PC NVIDIA. La première architecture privilégie la capacité compacte ; la seconde privilégie généralement le débit et la maturité CUDA.
La mémoire unifiée
Dans une architecture unifiée, CPU et GPU accèdent à une même réserve physique ou à un espace cohérent conçu pour limiter les copies. Apple Silicon est l’exemple le plus connu dans les ordinateurs compacts. Les puces AMD Ryzen AI Max utilisent également une grande quantité de mémoire LPDDR5x partagée et configurable pour les usages graphiques.
L’avantage pour l’IA locale est clair : le GPU intégré peut travailler sur un modèle qui dépasserait la VRAM d’une carte grand public. AMD annonce jusqu’à 128 Go de mémoire unifiée sur le Ryzen AI Max+ 395 et jusqu’à 96 Go configurables comme mémoire graphique sur certaines configurations. Cette allocation reste partagée avec le système et doit être contrôlée dans le BIOS ou les outils du constructeur.
« Unifiée » ne veut pas dire illimitée ni automatiquement plus rapide. Le CPU, le GPU, les applications et le cache se disputent la même capacité et la même bande passante. Une plateforme soudée doit aussi être correctement choisie dès l’achat : on ne remplace généralement pas ses puces LPDDR comme des barrettes SO-DIMM.
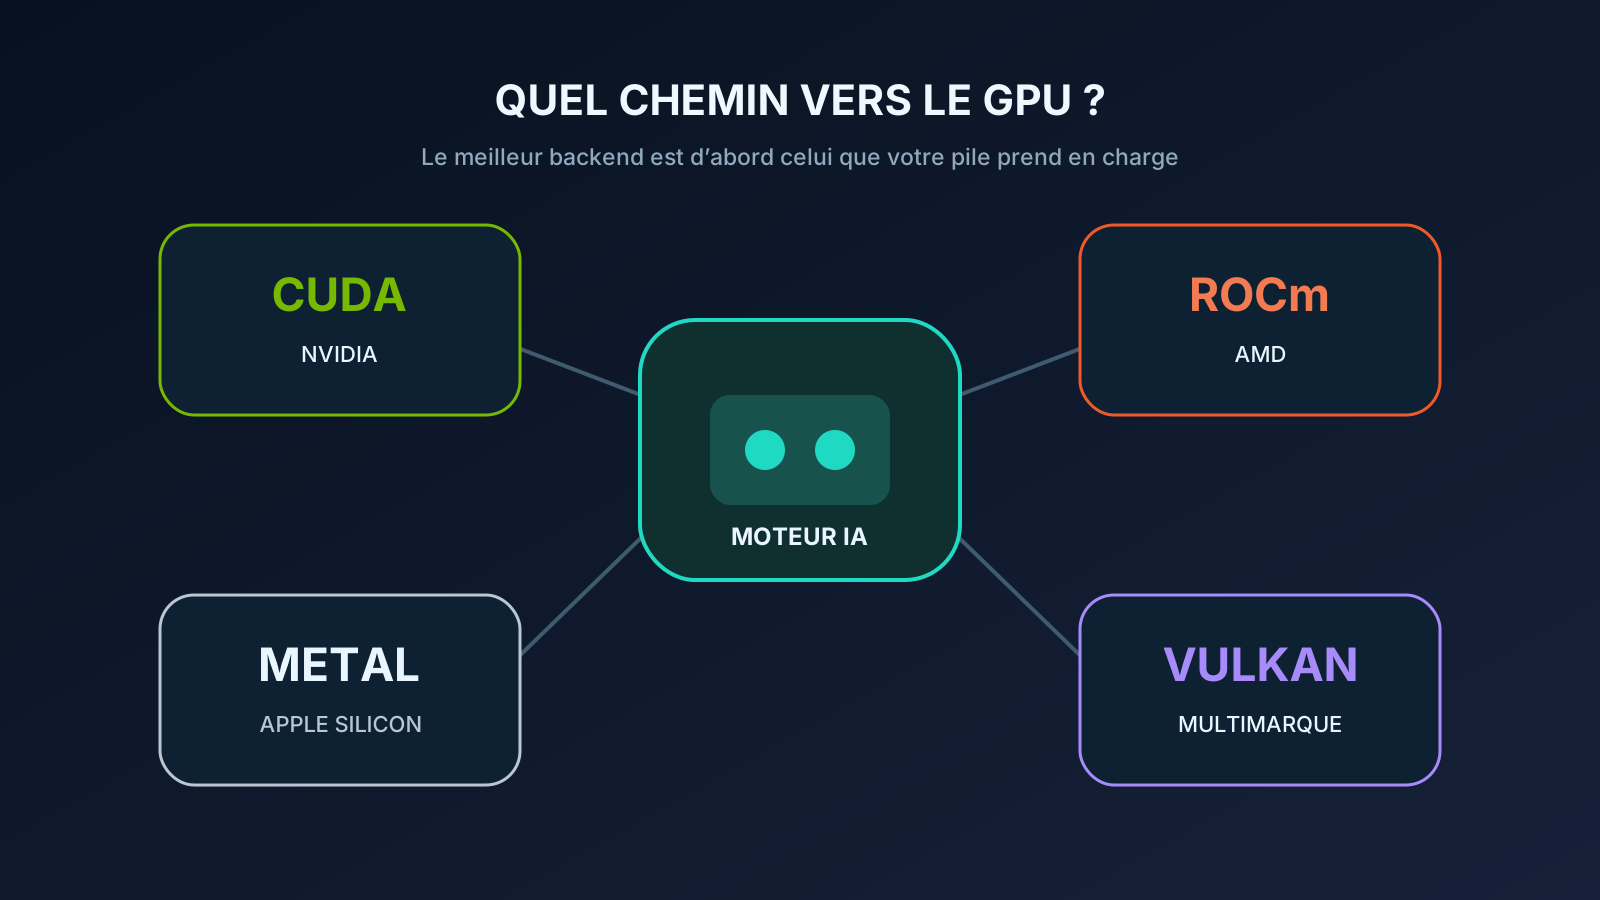
Sur Apple, Metal exploite cette architecture intégrée et des moteurs comme llama.cpp peuvent charger de nombreux modèles GGUF. Sur AMD, le résultat dépend de ROCm, Vulkan, du pilote et du logiciel. Une grande réserve sans backend opérationnel peut finir principalement utilisée par le CPU.
Quand le modèle déborde
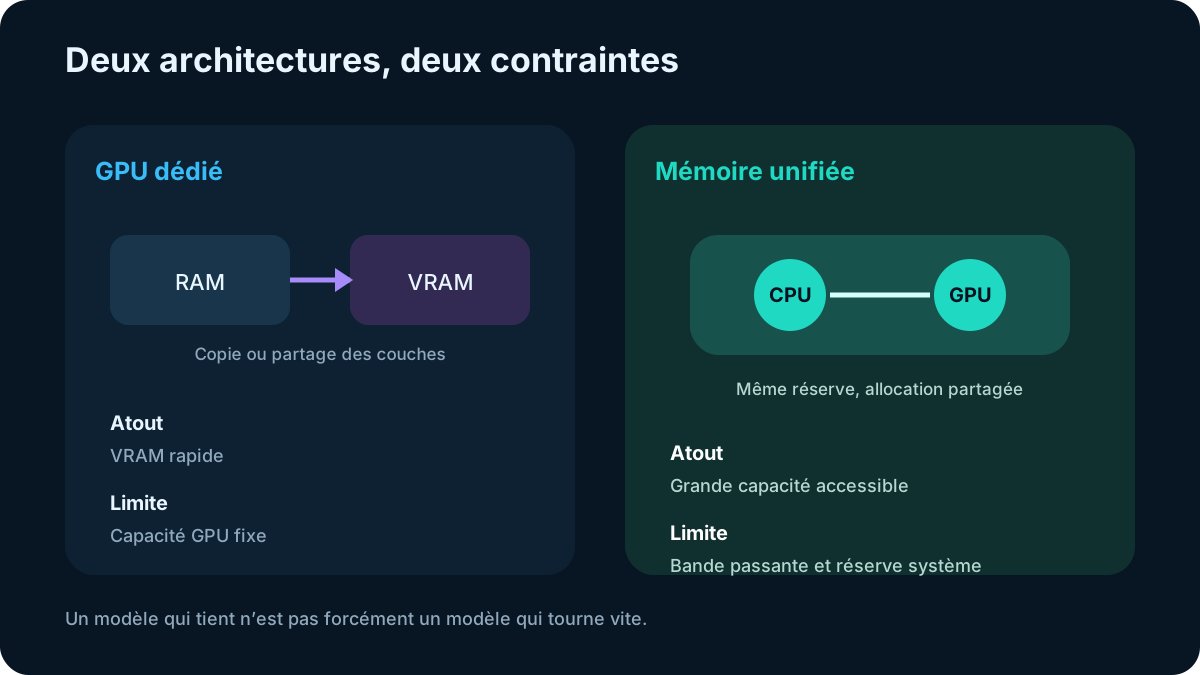
Lorsqu’un modèle dépasse la VRAM, le moteur peut laisser certaines couches en RAM et en envoyer d’autres au GPU. Ce partage permet de lancer le modèle, mais chaque passage entre les deux espaces ajoute une contrainte. Plus la partie CPU est importante, plus le débit se rapproche des limites de la mémoire système.
Avec une mémoire unifiée, il n’existe pas le même mur de copie entre RAM et VRAM dédiées, mais la réserve reste finie. Si le modèle, le cache et le système atteignent la limite, le système utilise le SSD ou refuse le chargement. La grande capacité repousse le problème sans le supprimer.
Le cache KV explique une partie des surprises. Il conserve les informations nécessaires au contexte et grandit avec la longueur de la conversation, le nombre de requêtes parallèles et les réglages du moteur. Une quantification de 40 Go peut donc fonctionner avec un petit contexte puis échouer quand plusieurs utilisateurs ouvrent de longues sessions.
Dans Ollama, la commande ollama ps indique si un modèle est entièrement sur GPU, entièrement sur CPU ou partagé. Cet affichage est plus instructif qu’un logo « Ryzen AI » ou « GeForce » sur une fiche commerciale : il révèle le chemin d’exécution réel.
Capacité et bande passante
La capacité se mesure en gigaoctets ; la bande passante décrit la quantité de données transférable par seconde. Les LLM relisent continuellement leurs poids pendant la génération. À matériel comparable, une bande passante supérieure améliore donc souvent le débit, surtout pour une session unique où le calcul n’est pas saturé par d’autres opérations.
Cela explique deux erreurs fréquentes. La première consiste à penser que 128 Go seront nécessairement deux fois plus rapides que 64 Go. Si le même modèle tient déjà, la capacité supplémentaire peut ne produire aucun gain. La seconde consiste à conclure qu’une carte à 24 Go est moins bonne qu’une machine à 64 Go : pour un modèle de 12 Go, la VRAM dédiée peut être beaucoup plus performante.
Le bon achat dépend du modèle prioritaire. Pour des 7B à 14B, une VRAM adaptée et rapide est attractive. Pour un 70B quantifié qui dépasse 32 Go, une mémoire unifiée de 64 ou 128 Go évite un partage plus sévère, au prix d’un débit qui doit être vérifié.
Lire une fiche technique
Repérez d’abord la capacité totale et son type : DDR5 en barrettes, LPDDR5x soudée ou GDDR dédiée. Vérifiez ensuite la configuration des canaux, la vitesse mémoire et la capacité maximale réellement supportée. Une seule barrette peut réduire la bande passante d’un iGPU qui dépend directement de la RAM.
Pour une carte dédiée, notez la VRAM exacte et non seulement le nom du GPU. Plusieurs variantes commerciales peuvent exister. Pour une mémoire unifiée, cherchez la limite d’allocation au GPU, la quantité réservée au système et la possibilité de modifier ce partage.
Enfin, contrôlez le backend dans le logiciel prévu. CUDA, ROCm, Metal et Vulkan ne sont pas des synonymes. La page CUDA, ROCm, Metal ou Vulkan montre comment relier le GPU, le système et le moteur avant l’achat.
Quel type privilégier
Privilégiez la RAM extensible pour un mini-PC économique, des modèles modestes et un usage CPU. Elle permet de corriger plus tard une capacité trop juste, mais vérifiez le double canal et n’attendez pas d’une simple extension un bond de vitesse.
Privilégiez la VRAM dédiée lorsque vos modèles tiennent entièrement dans la carte et que le débit, la création d’images ou l’écosystème CUDA sont prioritaires. Choisissez la capacité sur les modèles réellement utilisés, pas sur une hypothétique mise à niveau.
Privilégiez la mémoire unifiée pour charger de gros modèles dans un volume compact, notamment entre 40 et 90 Go. Elle est cohérente si le backend de votre application prend correctement en charge la puce et si vous acceptez une mémoire souvent non extensible.
Dans tous les cas, gardez une réserve. La meilleure configuration n’est pas celle qui affiche le maximum de gigaoctets, mais celle qui charge le modèle, conserve le contexte voulu et exécute toutes ses couches sur le chemin le plus efficace.
Voir la fiche pour dimensionner un mini-PC Ollama complet
Sources
Les caractéristiques ont été vérifiées le 24 août 2026 dans les spécifications AMD du Ryzen AI Max+ 395, le comparateur officiel NVIDIA GeForce et la documentation Apple sur la mémoire unifiée. Les allocations dépendent de la machine et du système.