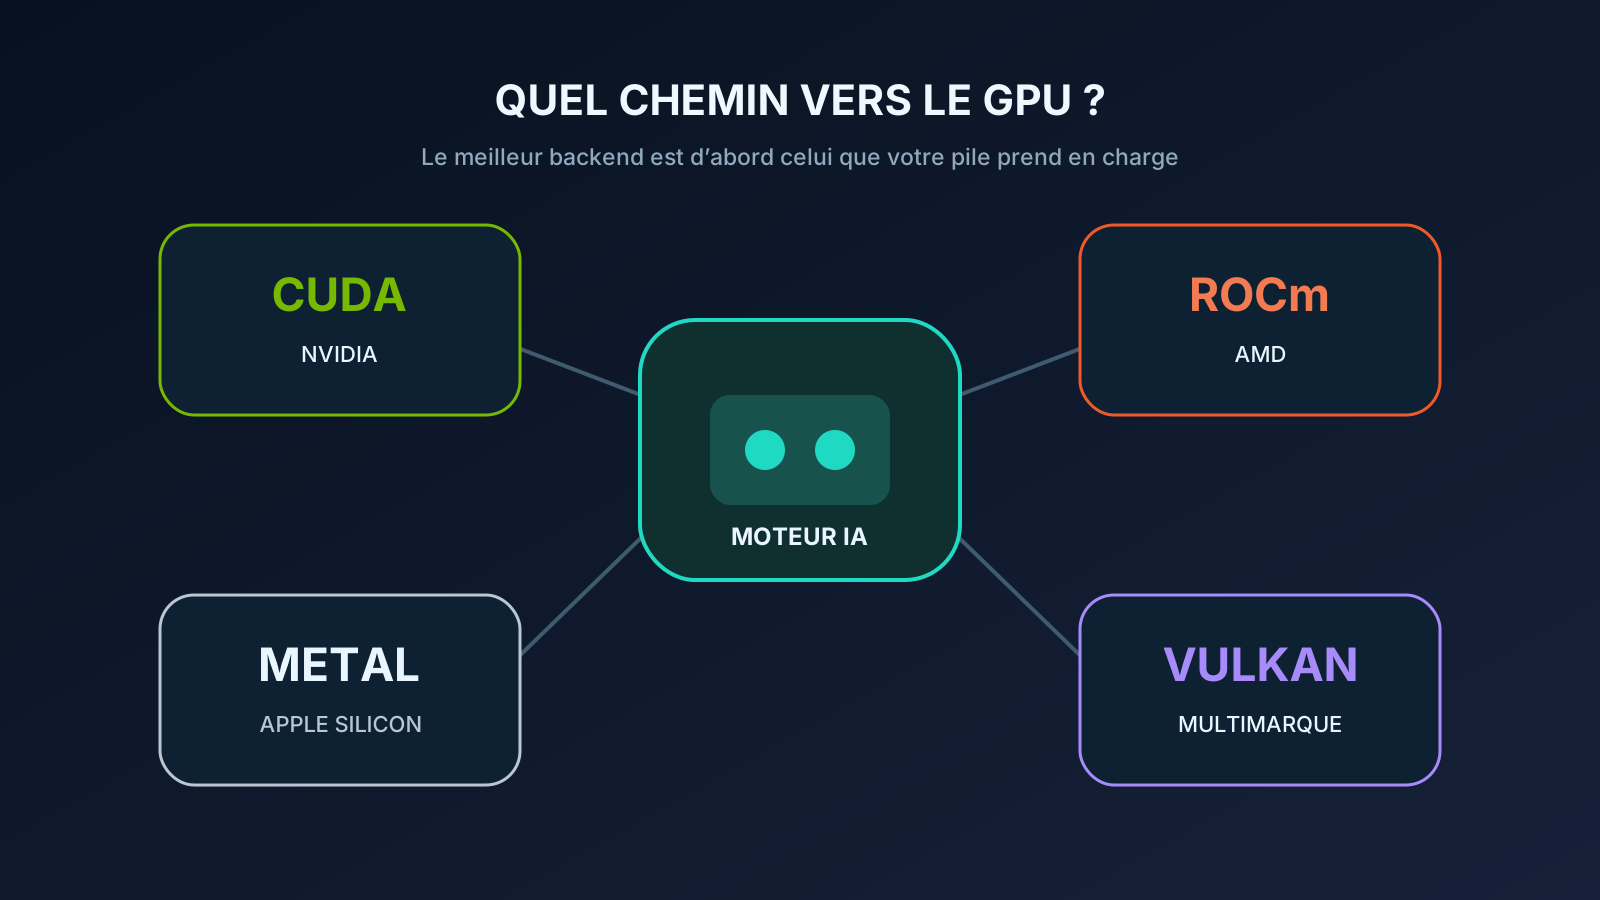
CUDA est la voie native de NVIDIA, ROCm celle d’AMD, Metal celle d’Apple et Vulkan une option plus transversale. Pour un mini-PC d’IA locale, le meilleur backend n’est pas théorique : c’est celui que votre moteur, votre GPU et vos pilotes exécutent réellement.
Le choix en tableau
| Backend | Matériel naturel | Point fort | Point de vigilance |
|---|---|---|---|
| CUDA | GPU NVIDIA | Écosystème IA mature et largement optimisé | Réservé à NVIDIA, capacité VRAM fixe |
| ROCm / HIP | GPU AMD pris en charge | Pile de calcul AMD, bibliothèques optimisées | Compatibilité à vérifier par GPU et système |
| Metal | Apple Silicon | Intégration étroite au GPU et à la mémoire unifiée | Écosystème Apple uniquement |
| Vulkan | GPU de plusieurs marques | Portabilité et couverture matérielle | Support IA parfois expérimental selon l’application |
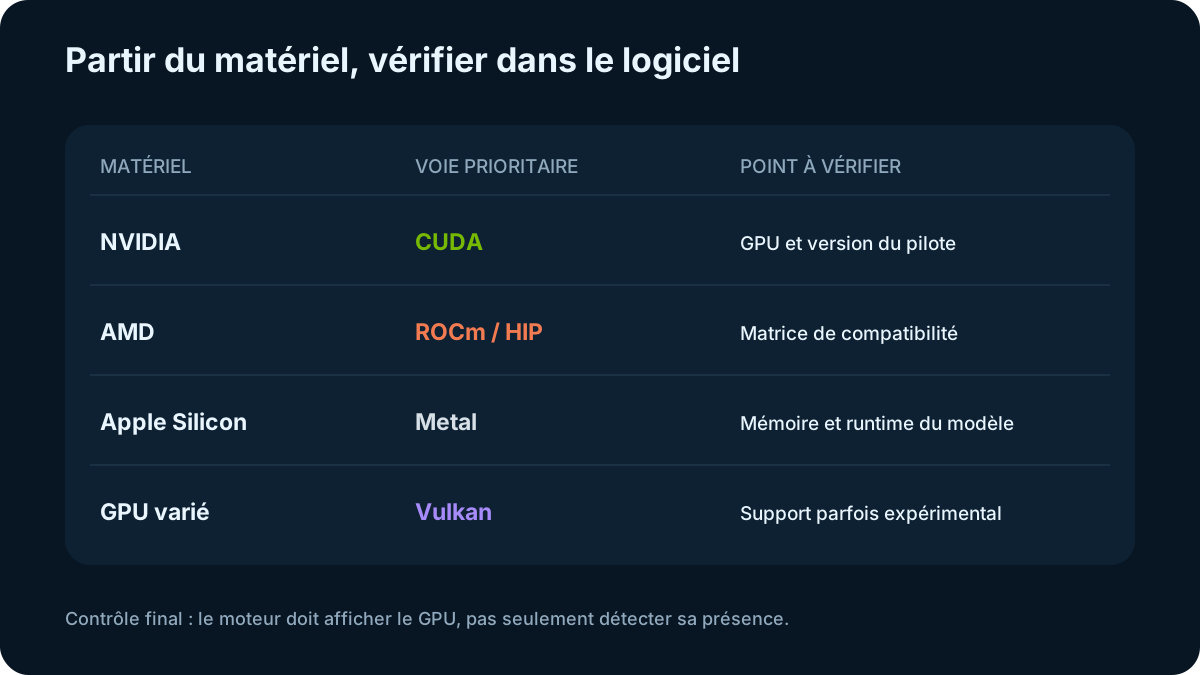
Le raccourci utile : NVIDIA appelle d’abord CUDA, AMD appelle d’abord ROCm si la matrice le confirme, Apple Silicon appelle Metal. Vulkan sert de voie portable ou de repli lorsque le moteur l’implémente correctement.
Voir la fiche de configuration et de vérification Ollama
CUDA sur NVIDIA
CUDA est la plateforme de programmation parallèle de NVIDIA. Elle comprend un modèle de programmation, des compilateurs, des bibliothèques et des outils capables d’exécuter des calculs sur les GPU de la marque. Dans l’IA, de nombreux frameworks et moteurs proposent CUDA comme chemin prioritaire.
Sur un mini-PC relié à un GPU NVIDIA ou sur une station compacte équipée d’une GeForce, cette maturité simplifie souvent l’installation. Ollama et llama.cpp prennent en charge CUDA, et les kernels optimisés permettent d’exploiter efficacement la VRAM. Il faut néanmoins que le pilote, la génération du GPU et la version du logiciel soient compatibles.
L’avantage logiciel ne supprime pas la limite matérielle. Une carte de 16 ou 24 Go ne peut pas garder entièrement en VRAM un modèle de plus de 40 Go. Le moteur peut décharger des couches en RAM, mais le débit baisse. CUDA est donc particulièrement convaincant quand le modèle prioritaire tient dans la VRAM disponible.
CUDA n’est pas une option générique à activer sur un GPU AMD ou Intel. Le nom apparaît parfois dans des comparaisons comme un synonyme d’accélération GPU, ce qui est trompeur. Il s’agit d’une technologie NVIDIA, et le choix du matériel engage cet écosystème.
ROCm sur AMD
ROCm est la pile logicielle ouverte d’AMD pour le calcul accéléré. Elle rassemble runtimes, compilateurs, utilitaires, bibliothèques mathématiques et intégrations avec des frameworks comme PyTorch. HIP fournit une interface de programmation conçue pour porter et développer des applications GPU.
Pour l’IA locale, la difficulté n’est pas de savoir si ROCm existe, mais si le GPU précis est pris en charge sur le système précis. Les matrices évoluent et peuvent différer entre Linux et Windows. Une puce AMD récente ne garantit pas à elle seule que chaque moteur utilisera ROCm dès l’installation.
Les Ryzen AI Max et certains GPU Radeon deviennent intéressants grâce à leur capacité mémoire, mais vérifiez la documentation de l’application. Ollama publie sa propre liste et propose aussi un chemin Vulkan. llama.cpp peut employer HIP pour les GPU AMD. Une prise en charge déclarée par ROCm et une intégration effective dans votre version du moteur sont deux validations distinctes.
Lorsque ROCm fonctionne nativement, il constitue généralement le premier choix sur AMD, car il donne accès à la pile et aux bibliothèques pensées pour ce matériel. Si le GPU n’est pas couvert ou si l’application ne l’intègre pas, Vulkan peut offrir une autre voie, avec des performances et une stabilité à mesurer.
Metal sur Apple Silicon
Metal est l’interface graphique et de calcul d’Apple. Elle donne un accès direct aux GPU Apple et s’intègre à la mémoire unifiée des Mac à puce Apple Silicon. llama.cpp l’utilise pour accélérer les modèles GGUF, tandis que des logiciels comme LM Studio peuvent également exploiter des modèles au format MLX.
La simplicité vient de la cohérence de la plateforme : matériel, pilotes et système évoluent ensemble. Un Mac mini ne demande pas de choisir un pilote NVIDIA ou une distribution ROCm. Cette intégration réduit certaines variables, sans rendre tous les modèles ni tous les formats équivalents.
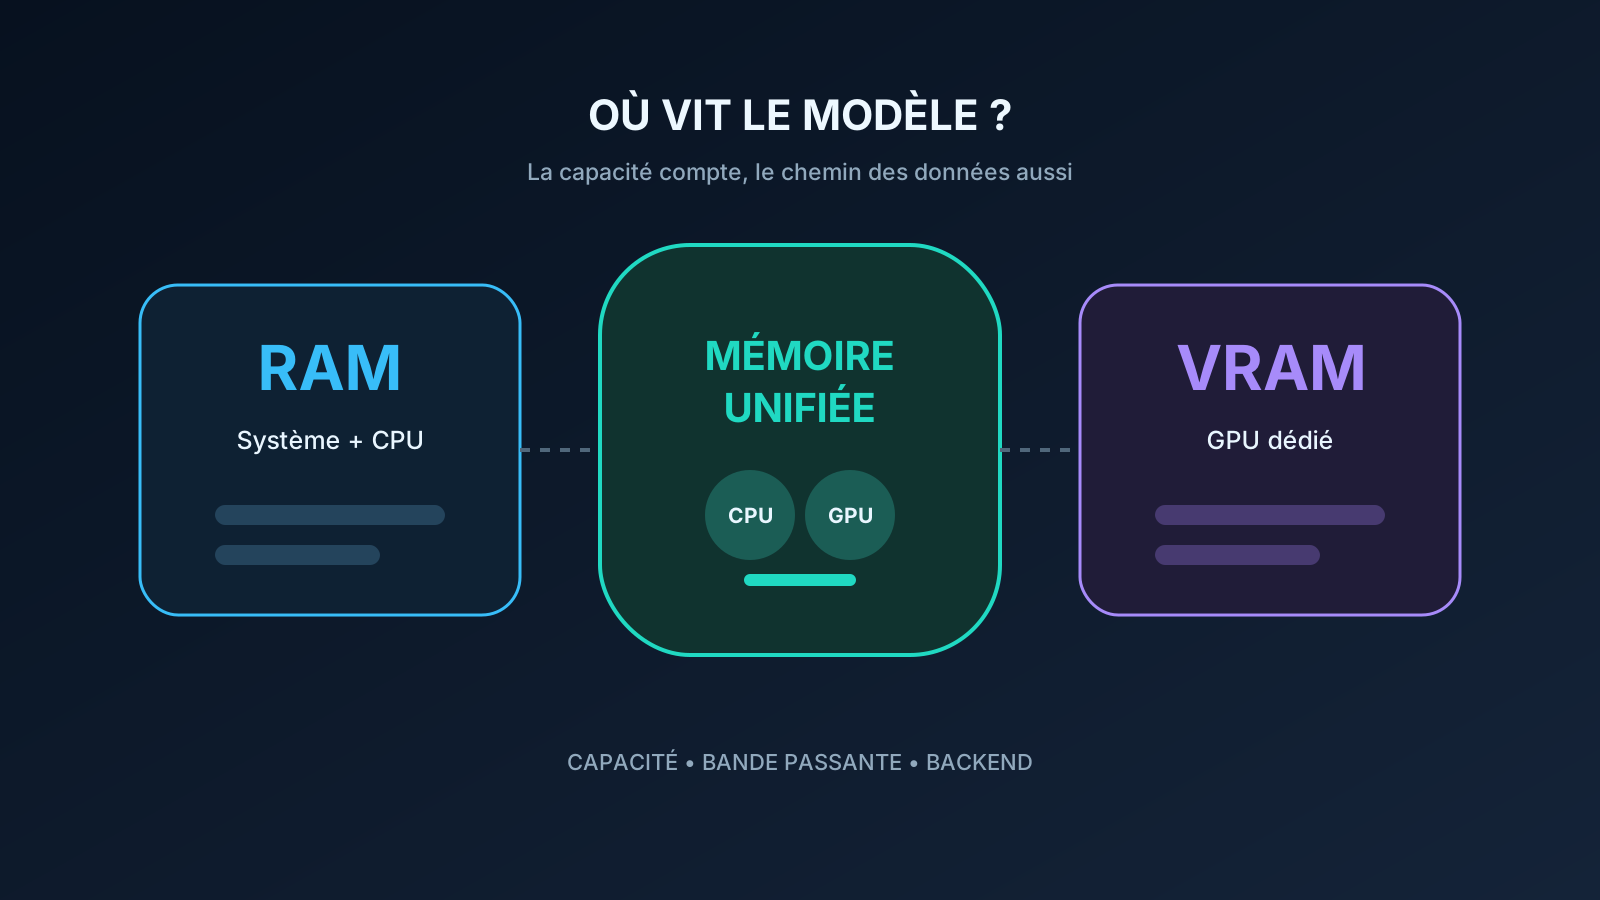
La mémoire unifiée autorise le GPU à accéder à une part importante de la réserve commune. Un modèle plus grand peut ainsi être chargé sans carte graphique dédiée. La bande passante dépend néanmoins de la puce et de sa configuration ; la quantité achetée est généralement définitive.
Metal reste propre aux plateformes Apple. Un workflow conçu autour de CUDA ou d’une bibliothèque non portée ne bascule pas automatiquement. Avant de choisir un Mac pour un outil précis, contrôlez le moteur utilisé, la disponibilité du modèle et les fonctions réellement accélérées.
Vulkan en voie portable
Vulkan est une interface ouverte du Khronos Group, disponible sur des GPU de plusieurs constructeurs. Les compute shaders y sont obligatoires, ce qui autorise des calculs sans rendu graphique, y compris des charges liées à l’IA. Des moteurs comme llama.cpp disposent d’un backend Vulkan.
Cette portée en fait une option précieuse sur des iGPU AMD ou Intel, ou lorsqu’une pile propriétaire n’est pas disponible. Elle peut permettre au même moteur de couvrir davantage de machines avec un chemin commun. « Portable » ne signifie toutefois pas « identique » : les pilotes, extensions, kernels et performances varient fortement.
Dans Ollama, le support Vulkan est encore présenté comme expérimental à la date de notre vérification. Il faut donc s’attendre à des différences entre versions et modèles de GPU. Une détection réussie n’est pas suffisante ; chargez un modèle, contrôlez son placement et testez une session prolongée.
Vulkan n’est pas nécessairement le second choix en qualité, car les poids du modèle restent les mêmes. La différence porte sur l’exécution : kernels disponibles, formats accélérés, gestion de la mémoire et stabilité. Comparez le débit et les erreurs avec le backend natif lorsqu’il existe.
Le logiciel décide
Un backend n’accélère rien tant que l’application ne l’appelle pas. Ollama, LM Studio, llama.cpp et un framework Python ne proposent pas exactement les mêmes versions, formats ou réglages. Deux logiciels installés sur la même machine peuvent donc employer des chemins différents et afficher des débits éloignés.
Commencez par la documentation du moteur, puis vérifiez le pilote et le GPU. Sur Ollama, ollama ps affiche un placement CPU, GPU ou mixte. Dans LM Studio, contrôlez le runtime sélectionné et le nombre de couches déchargées. Dans llama.cpp, les journaux de démarrage indiquent le backend et les périphériques détectés.
Attention au NPU. Les TOPS annoncés pour une puce IA ne prouvent pas qu’Ollama ou votre modèle l’utilise. Les chemins courants restent CPU, CUDA, ROCm, Metal et Vulkan. Notre guide NPU et TOPS explique pourquoi cette métrique ne remplace pas une liste de compatibilité.
Le format du modèle intervient également. GGUF se prête à llama.cpp et à ses différents backends. Une méthode pensée pour CUDA peut ne pas disposer du même support sur Metal ou Vulkan. Choisissez donc le trio modèle–moteur–backend, pas chaque élément séparément.
Comparer sans se tromper
Pour comparer deux backends, utilisez la même machine lorsque c’est possible, le même fichier de modèle, la même quantification et la même longueur de contexte. Fixez le nombre de couches sur GPU et les paramètres de génération. Relevez le temps avant le premier token, le débit, la mémoire consommée et la stabilité thermique.
Un test de trente secondes favorise parfois une machine qui réduit sa fréquence après plusieurs minutes. Lancez plusieurs réponses longues et laissez la température se stabiliser. Sur un mini-PC, le refroidissement et la limite de puissance peuvent compter autant que le backend théorique.
Ne comparez pas un 7B Q4 sous Vulkan à un 14B Q5 sous CUDA pour conclure sur les interfaces. De même, une couche restée sur CPU fausse la lecture. Le guide Ollama ou LM Studio détaille les variables à conserver lorsque vous changez d’application.
Enfin, jugez la compatibilité fonctionnelle : contexte maximal stable, modèles multimodaux, lots, requêtes parallèles et reprise après veille. Le meilleur score brut perd son intérêt si le service plante ou si une fonction centrale retombe silencieusement sur CPU.
Quel backend choisir
Choisissez CUDA avec un GPU NVIDIA lorsque vos modèles tiennent dans la VRAM et que vous voulez l’écosystème le plus largement optimisé. C’est un choix solide pour le débit, le développement et les outils qui ciblent explicitement NVIDIA.
Choisissez ROCm sur un GPU AMD officiellement pris en charge par votre système et votre moteur. Vérifiez la matrice avant l’achat, surtout pour un iGPU ou sous Windows. Sur Ryzen AI Max, cette voie valorise la grande mémoire disponible lorsqu’elle est correctement intégrée.
Choisissez Metal sur Apple Silicon. Il est le chemin naturel des applications natives et de llama.cpp sur Mac. Dimensionnez la mémoire unifiée dès l’achat et vérifiez que votre format ou votre framework possède une implémentation Apple satisfaisante.
Essayez Vulkan pour couvrir un GPU varié ou contourner l’absence d’un chemin natif dans l’application. Traitez une mention « expérimentale » comme une invitation à tester, pas comme une promesse de production.
Si deux options fonctionnent, mesurez-les sur votre charge. Le backend est un maillon d’une chaîne qui comprend le modèle, la quantification, la mémoire, le pilote et le refroidissement. Aucun logo ne remplace cette chaîne complète.
Voir la fiche Strix Halo ou NVIDIA selon votre modèle
Sources
La synthèse a été contrôlée le 24 août 2026 dans la documentation matérielle d’Ollama, la liste des backends de llama.cpp et la présentation officielle de ROCm. Les compatibilités changent avec les pilotes et versions.