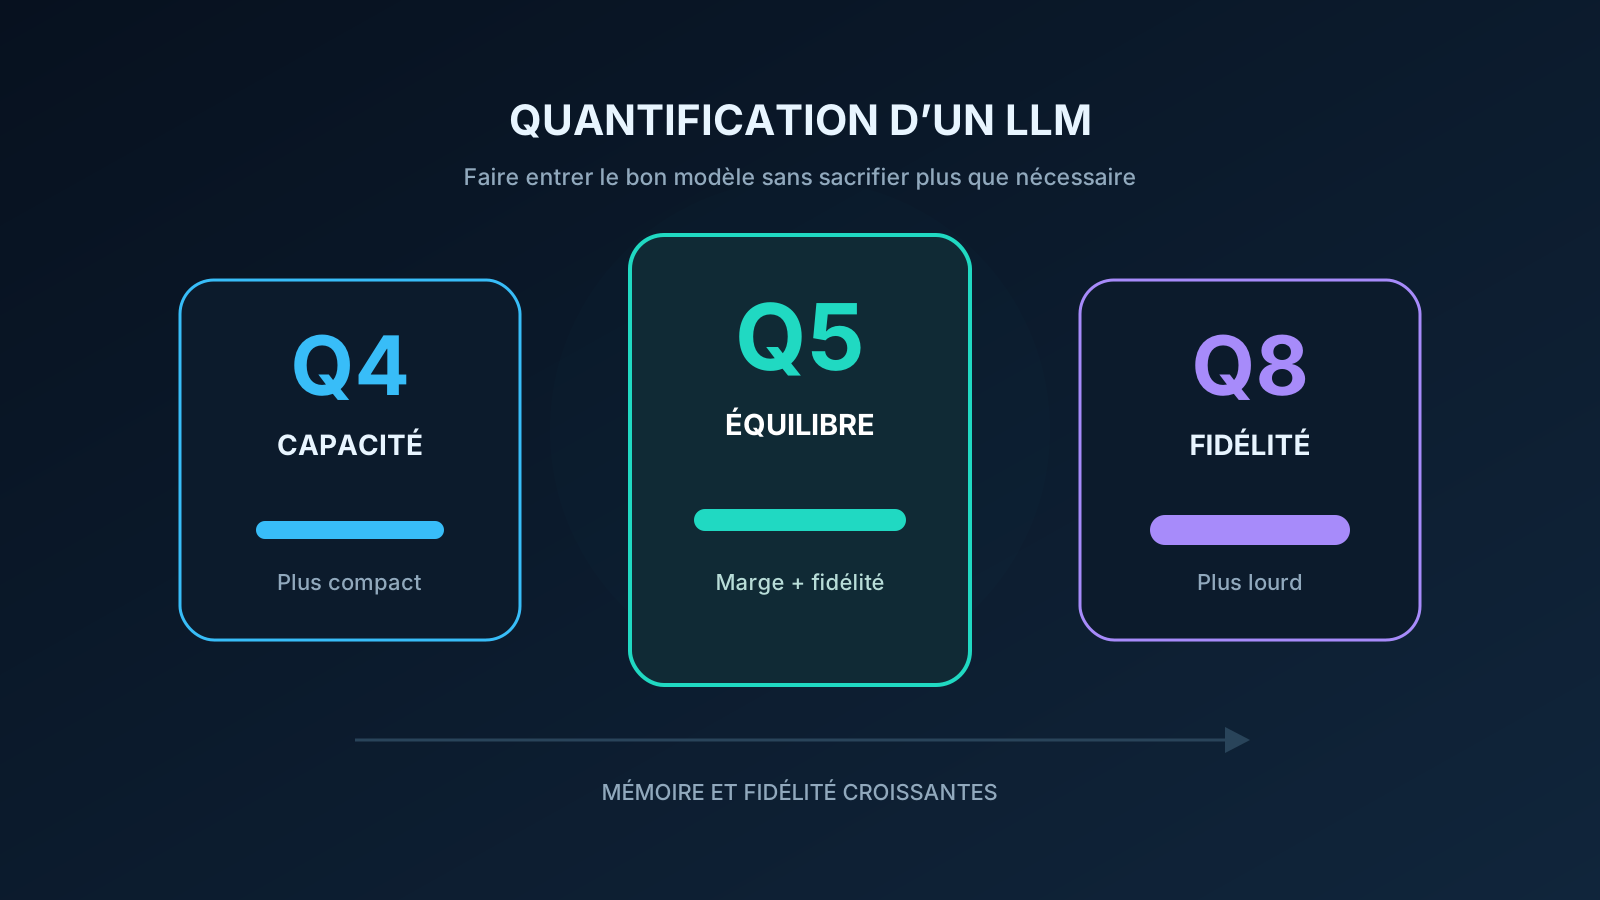
Q4 réduit fortement l’empreinte d’un LLM, Q5 ménage un compromis confortable et Q8 conserve davantage d’information. Le bon format dépend pourtant moins d’une étiquette que de votre mémoire disponible, du modèle exact et du travail demandé.
Le choix en tableau
| Format | Priorité | Atout | Limite | Profil conseillé |
|---|---|---|---|---|
| Q4 | Faire entrer le modèle | Fichier compact, marge pour le contexte | Perte plus visible sur certaines tâches exigeantes | Usage local courant, mémoire contrainte |
| Q5 | Équilibrer | Fidélité supérieure à Q4 pour un surcoût mesuré | Moins de marge mémoire | Modèle quotidien, machine bien dimensionnée |
| Q8 | Préserver | Représentation proche des poids à plus haute précision | Fichier et mémoire nettement plus lourds | Évaluation, tâches sensibles, capacité abondante |
Notre repère pratique : commencez par Q5_K_M si le modèle tient avec une réserve correcte. Descendez en Q4_K_M pour gagner une classe de taille ou du contexte. Montez en Q8 seulement si vous pouvez mesurer un bénéfice utile.
Voir la fiche des configurations adaptées à Ollama
Ce que les bits changent
Les poids d’un modèle sont des nombres. Leur précision d’origine peut être réduite après l’entraînement afin d’occuper moins d’espace. Cette quantification post-entraînement représente les valeurs avec moins de bits et introduit des arrondis. Le gain est immédiat sur le disque et dans la mémoire ; la contrepartie est une approximation supplémentaire.
Q4, Q5 et Q8 désignent des familles à quatre, cinq ou huit bits par poids, mais le nombre inscrit dans le nom ne suffit pas à calculer la taille finale. Les métadonnées, certaines couches conservées dans un autre format et la méthode choisie modifient le résultat. Deux fichiers Q4 issus du même modèle peuvent donc peser différemment et ne pas offrir exactement la même qualité.
La quantification ne réduit pas le nombre de paramètres ni la longueur maximale de contexte prévue par l’architecture. Elle modifie la façon dont les poids sont stockés et calculés. Le cache de contexte, les tampons du moteur et les composants multimodaux peuvent employer d’autres précisions. Voilà pourquoi un fichier de 20 Go ne garantit jamais une consommation totale de 20 Go.
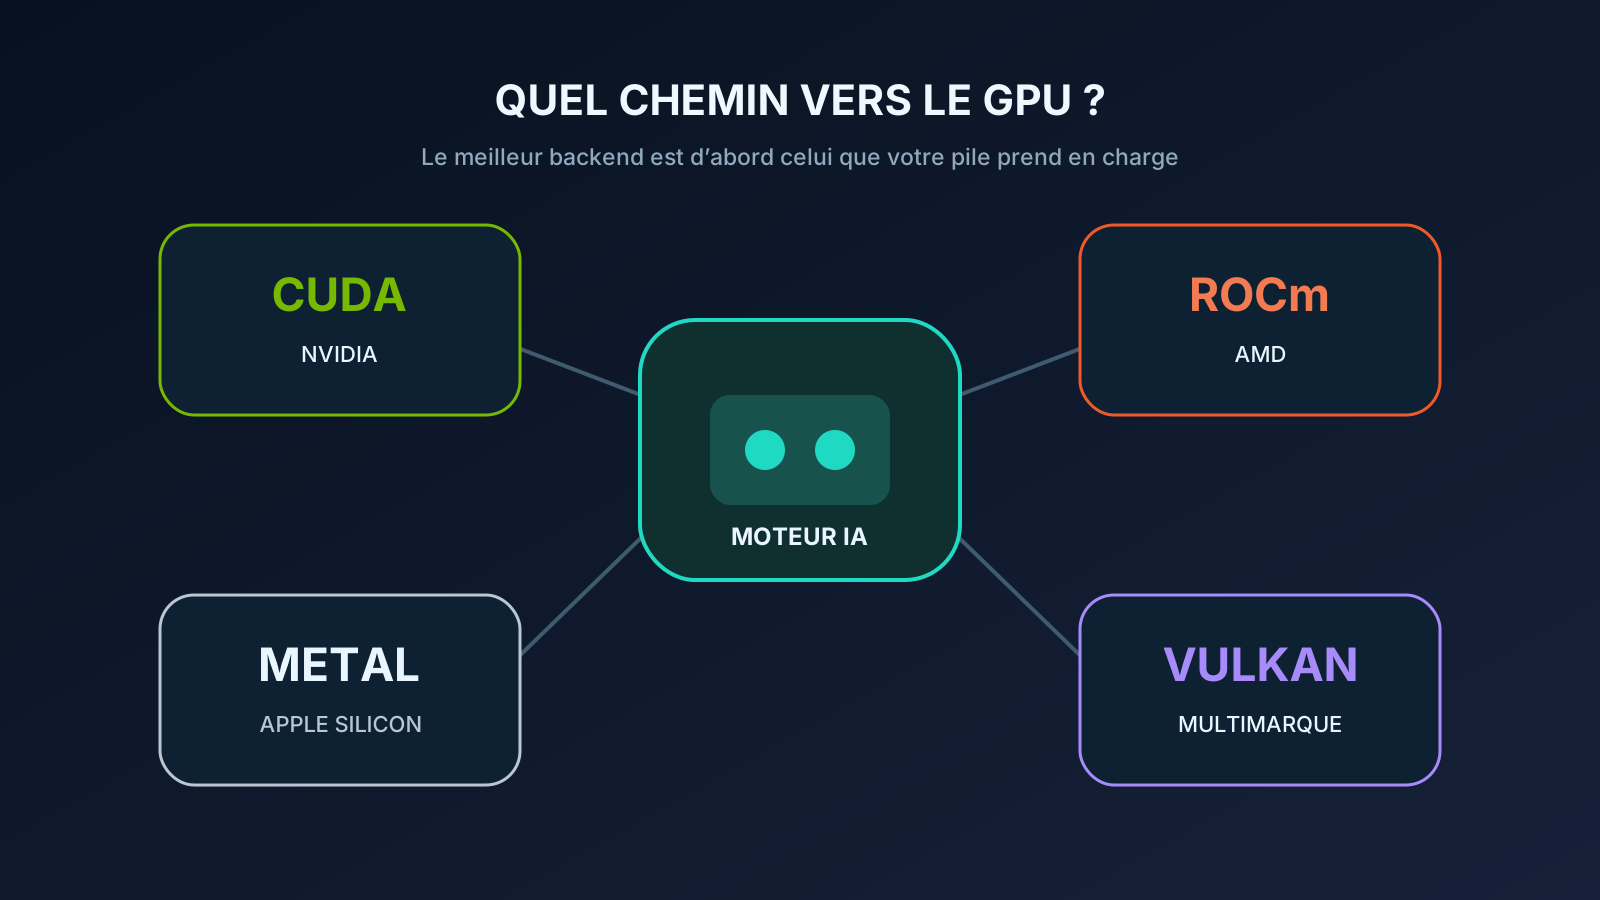
Le moteur compte aussi. GGUF et llama.cpp dominent les usages CPU et de nombreux mini-PC, tandis que d’autres méthodes comme AWQ ou GPTQ ciblent des piles différentes. Comparez des variantes exécutées par le même logiciel et le même backend. Une différence attribuée à Q4 ou Q5 peut sinon venir d’un kernel, d’un pilote ou d’un paramètre de chargement.
Q4 pour faire entrer
Q4 est souvent le premier choix quand la capacité bloque. Dans la documentation de llama.cpp, Llama 3.1 8B passe d’environ 32,1 Go en précision d’origine à 4,9 Go en Q4_K_M ; le 70B passe d’environ 280,9 Go à 43,1 Go. Ces ordres de grandeur expliquent pourquoi des modèles auparavant réservés aux serveurs deviennent chargeables sur une station compacte.
Le principal bénéfice n’est pas seulement de charger plus gros. Une variante Q4 laisse aussi davantage de place au cache KV, au système, à une base vectorielle et aux requêtes parallèles. Sur une machine de 64 Go, cette marge peut être plus utile qu’une quantification plus fidèle qui pousse le système vers l’échange disque.
La perte n’est pas uniforme. Une conversation simple peut rester très convaincante, alors qu’un raisonnement fragile, du code complexe, une langue moins représentée ou une tâche de classement fin révèle davantage les approximations. La bonne question n’est donc pas « Q4 est-il bon ? », mais « Q4 reste-t-il assez fiable sur mon jeu de tâches ? ».
Pour découvrir un modèle ou vérifier qu’il répond à votre besoin, Q4_K_M constitue un point de départ réaliste. Conservez une série de consignes représentatives, notez les erreurs importantes et comparez ensuite Q5 sur les mêmes entrées. Un test quotidien vaut mieux qu’un classement universel établi sur une autre machine.
Q5 pour équilibrer
Q5 augmente la précision des poids et la taille du fichier sans revenir au coût de Q8. Il convient lorsque Q4 fonctionne déjà mais montre des hésitations sur les tâches qui vous importent, ou lorsque la machine dispose d’assez de mémoire pour absorber le surcoût sans réduire le contexte.
Le suffixe Q5_K_M est fréquemment proposé comme variante équilibrée dans les catalogues GGUF. Le « M » ne signifie pas que tous les poids sont uniformément en cinq bits : les variantes K utilisent des blocs et peuvent affecter des précisions différentes à certaines matrices. Cette répartition explique qu’un format mixte puisse préserver des parties sensibles du modèle.
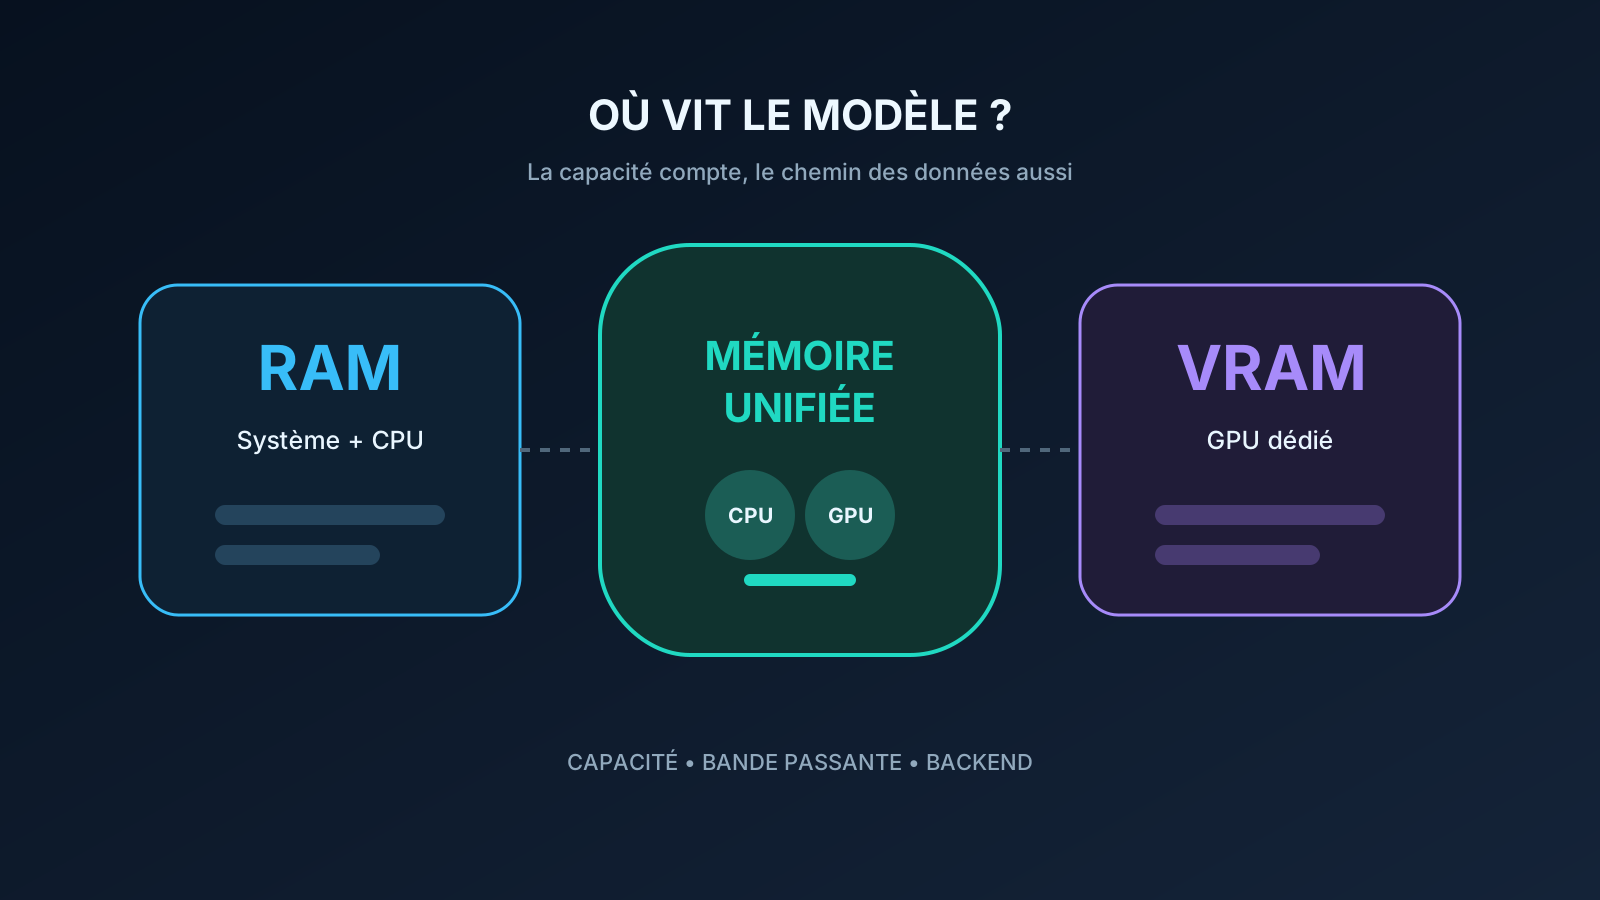
Sur un 7B ou un 8B, la différence absolue de taille reste souvent facile à absorber avec 32 Go. Sur un 70B, quelques bits supplémentaires par poids représentent plusieurs gigaoctets et peuvent changer complètement le partage entre accélérateur et CPU. Vérifiez toujours la taille réelle publiée, puis ajoutez la réserve de fonctionnement décrite dans notre page sur la RAM, la VRAM et la mémoire unifiée.
Q5 n’est pas automatiquement plus rapide ou plus lent. Un fichier plus compact réduit les transferts, mais le matériel peut traiter certains formats plus efficacement que d’autres. Le débit doit être mesuré avec le même moteur, le même contexte et le même nombre de couches placées sur le GPU.
Q8 pour préserver
Q8 réduit encore l’écart avec une représentation flottante, au prix d’un volume proche du double de Q4 pour les poids concernés. Ce format devient intéressant lorsque la mémoire n’est plus la contrainte et que de petites variations de sortie coûtent davantage que quelques gigaoctets : évaluation interne, extraction structurée délicate ou comparaison d’une quantification plus agressive.
Il serait toutefois excessif de l’exiger pour toute production. Si Q5 donne les mêmes décisions, la même qualité de code et les mêmes réponses acceptables sur votre corpus, Q8 immobilise de la mémoire sans bénéfice opérationnel. Cette mémoire pourrait servir à une fenêtre de contexte plus grande ou à plusieurs utilisateurs.
Q8 peut aussi servir de référence pratique lorsqu’un fichier en précision complète est trop lourd. Il ne devient pas pour autant une vérité absolue : une réponse générative varie avec la consigne, la graine et les paramètres. Comparez plusieurs essais et utilisez des critères adaptés au travail plutôt qu’une impression sur une seule conversation.
Les suffixes K, M et S
Les noms GGUF comportent souvent plusieurs éléments : Q4_0, Q4_1, Q4_K_S ou Q4_K_M. Les variantes K sont des schémas de quantification par blocs. Les lettres S et M distinguent notamment une petite variante et une variante mixte. Elles ne constituent pas une note officielle valable pour toutes les architectures.
Ne remplacez donc pas la comparaison du fichier par un raccourci du type « tout Q4 se vaut ». Consultez la fiche du modèle, l’outil qui a produit la quantification et, si elle est disponible, l’utilisation d’une matrice d’importance. llama.cpp permet d’employer cette matrice pour mieux protéger les poids importants pendant l’opération.
Évitez aussi de re-quantifier un fichier déjà fortement compressé. La seconde opération part de valeurs déjà arrondies et peut cumuler les pertes. Préférez une variante produite depuis les poids originaux ou une source de plus haute précision, avec une provenance et une licence clairement indiquées.
Mesurer sur sa machine
Préparez dix à vingt tâches qui reflètent vraiment votre usage : résumé fidèle, fonction de code avec tests, extraction JSON, questions sur vos documents et réponses en français. Fixez le modèle, la consigne système, la température, le contexte et le moteur. Comparez ensuite Q4, Q5 et éventuellement Q8 sans changer plusieurs variables à la fois.
Mesurez quatre choses : la réussite de la tâche, la taille en mémoire, le temps avant le premier token et le débit de génération. Ajoutez la stabilité lors de longues sessions. Une variante légèrement plus rapide mais qui oblige à raccourcir les documents peut être moins utile au quotidien.
Dans Ollama, ollama ps aide à voir si le modèle est chargé sur GPU, CPU ou partagé entre les deux. Un changement de quantification peut faire tenir toutes les couches sur l’accélérateur et produire un gain plus important que la différence théorique entre deux formats. Notre comparatif Ollama ou LM Studio détaille une méthode de comparaison cohérente.
Quel format choisir
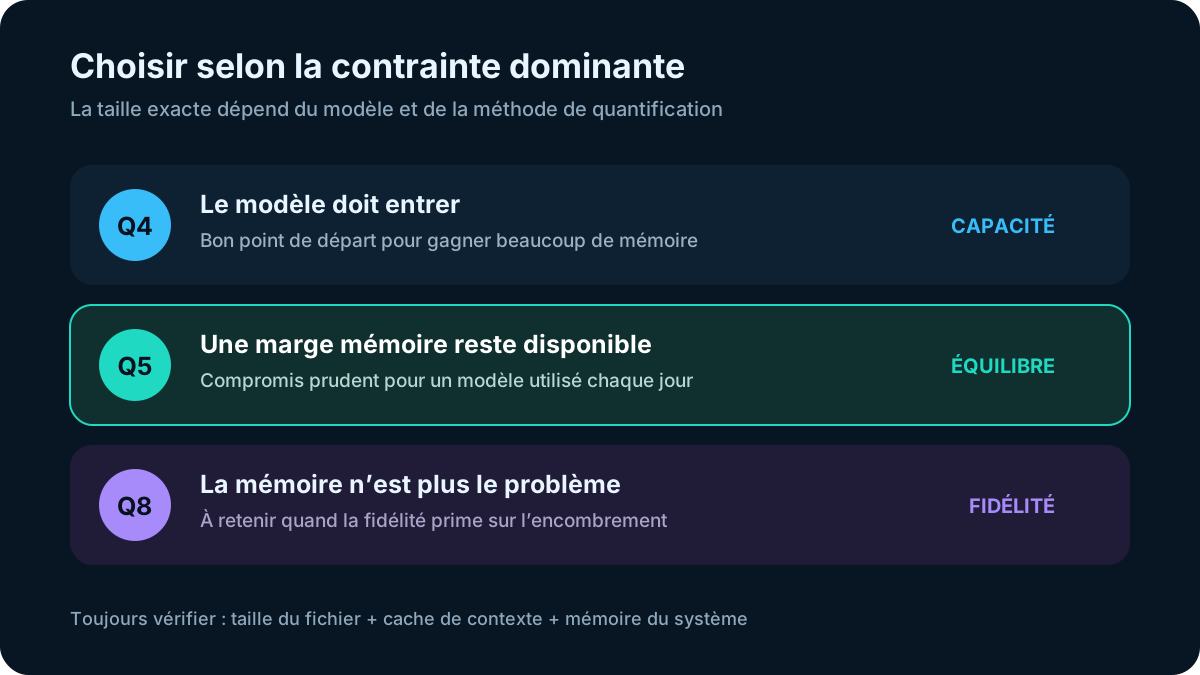
Choisissez Q4_K_M lorsque le modèle serait autrement trop gros, que vous avez besoin de contexte ou que vous explorez plusieurs modèles. C’est souvent le meilleur moyen d’accéder à une classe de paramètres supérieure sur un mini-PC.
Choisissez Q5_K_M lorsque Q4 tient très facilement et que le modèle est utilisé chaque jour pour du code, de la rédaction ou de l’extraction. Le supplément de mémoire achète une marge de fidélité raisonnable sans atteindre le coût de Q8.
Choisissez Q8 si la capacité est abondante, si les sorties sensibles justifient une vérification et si vos tests montrent une amélioration. Ne l’achetez pas comme symbole de qualité : mesurez le bénéfice et gardez de la place pour le contexte.
Enfin, si aucune variante ne tient correctement, réduisez la taille du modèle avant de forcer une quantification extrême. Un bon 14B en Q5 peut être plus régulier qu’un 32B écrasé dans un format très bas. La quantification est un levier de dimensionnement, pas une règle selon laquelle le plus gros modèle gagne toujours.
Voir la fiche pour choisir entre 64 Go et 128 Go
Sources
Les repères ont été vérifiés le 24 août 2026 dans la documentation de quantification de llama.cpp, le guide conceptuel de Hugging Face et le catalogue Llama 3.1 d’Ollama. Les résultats varient selon le modèle, le moteur et le matériel.