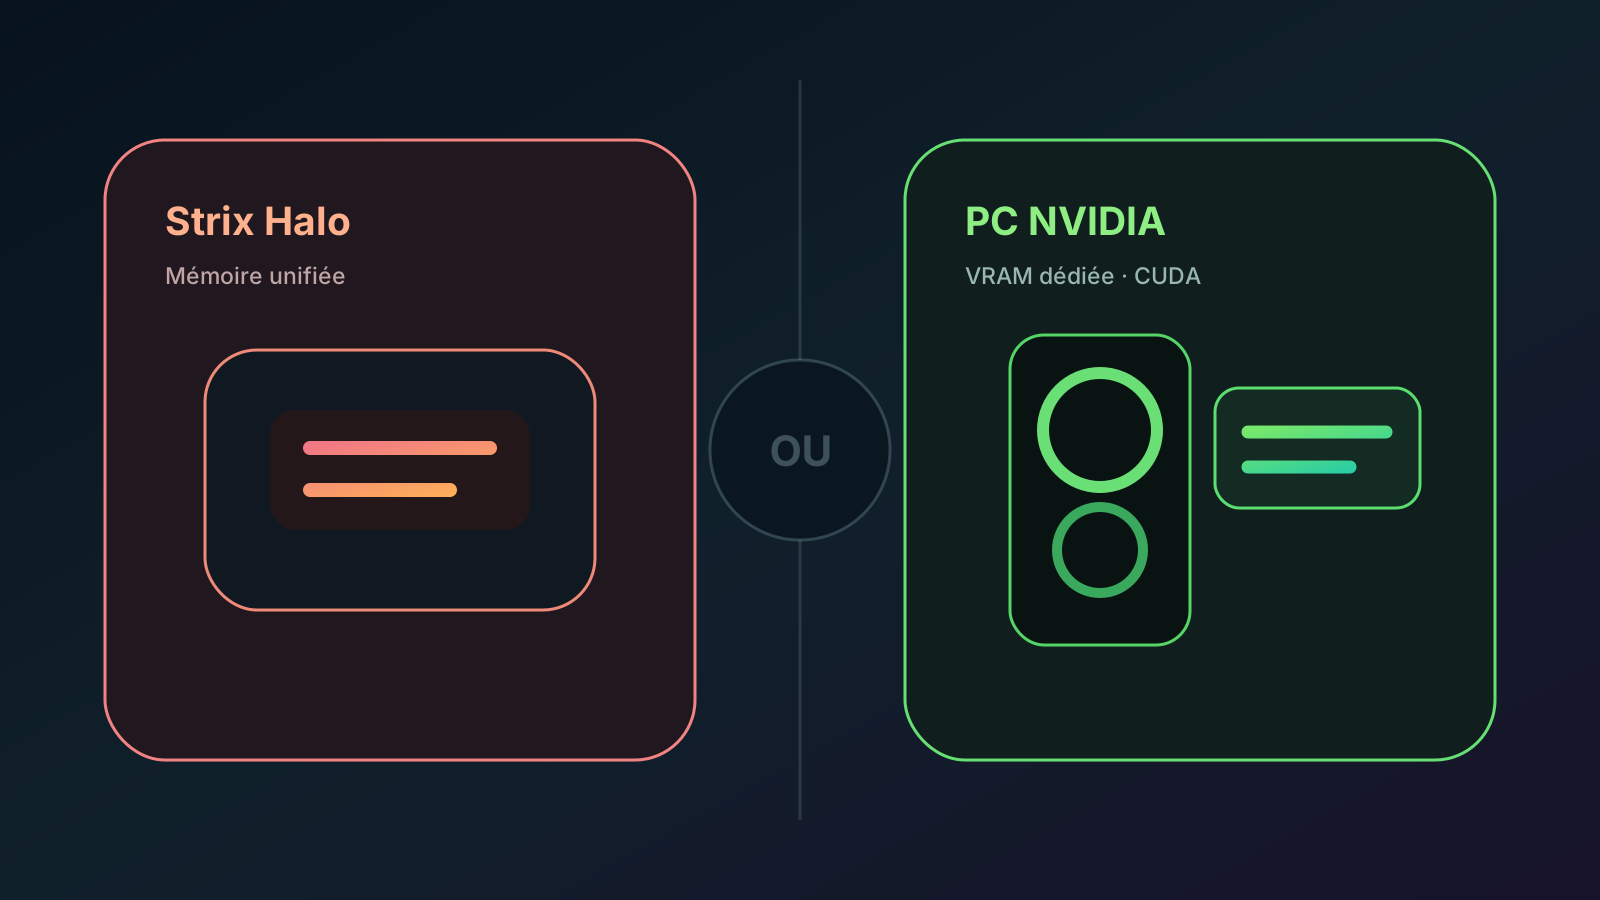
Strix Halo et NVIDIA ne gagnent pas sur le même terrain. Un mini-PC Ryzen AI Max peut consacrer une grande part de sa mémoire unifiée à un modèle volumineux ; une GeForce offre généralement un meilleur débit et une compatibilité logicielle plus directe quand le modèle tient dans sa VRAM.
Le choix en tableau
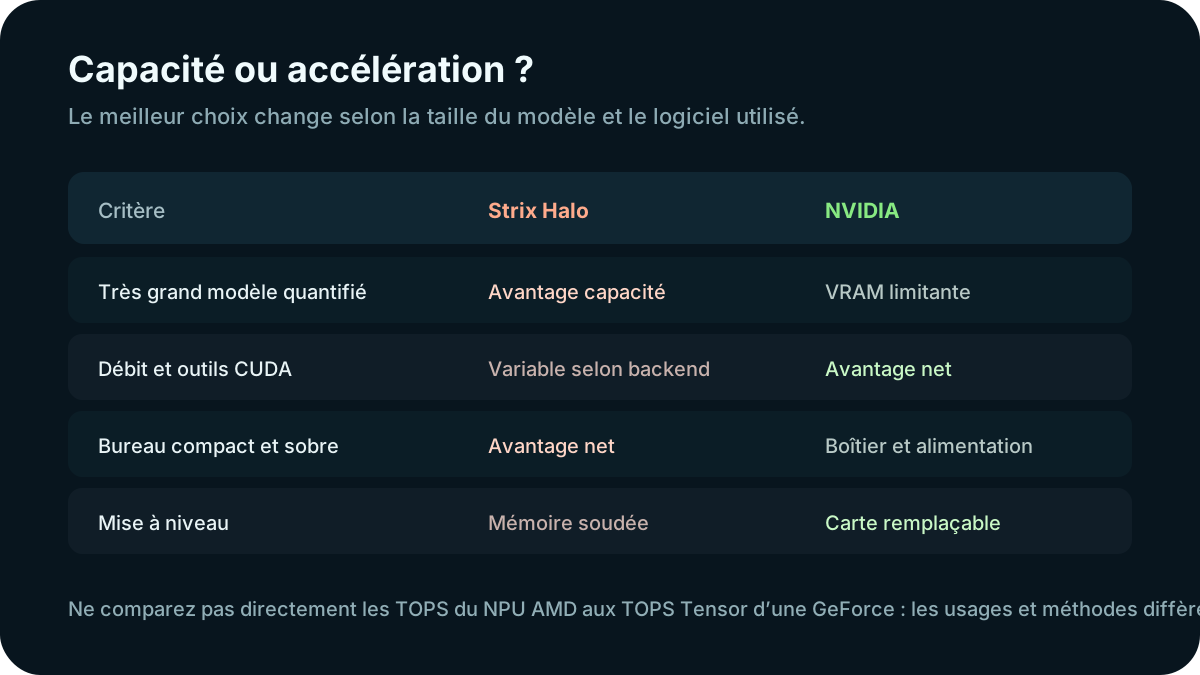
| Critère | Mini-PC Strix Halo | PC avec NVIDIA |
|---|---|---|
| Mémoire pour le modèle | Jusqu’à 128 Go système, jusqu’à 96 Go affectables au GPU selon AMD | 12 Go sur RTX 5070, 16 Go sur 5070 Ti/5080, 32 Go sur 5090 |
| Débit sur modèle compatible | Bon, dépendant du backend et des pilotes | Avantage fréquent grâce à CUDA et à la bande passante dédiée |
| Très gros modèle quantifié | Avantage capacité | Partage CPU/GPU si la VRAM est dépassée |
| Compacité | Excellent, plateforme tout-en-un | Boîtier et alimentation plus volumineux |
| Évolutivité | Mémoire généralement soudée | Carte graphique remplaçable |
| Écosystème IA | ROCm ou Vulkan selon le logiciel | CUDA très largement pris en charge |
Choisissez Strix Halo pour faire entrer un grand modèle dans un appareil compact. Choisissez NVIDIA pour maximiser le débit, la compatibilité CUDA et la possibilité de remplacer la carte. Pour un modèle 8B à 32B, la GeForce adaptée garde souvent l’avantage pratique ; pour un 70B et au-delà, la capacité unifiée change le calcul.
Déterminer d’abord si votre modèle exige 64 Go ou 128 Go
Strix Halo pour la capacité
Le Ryzen AI Max+ 395 réunit seize cœurs Zen 5, une Radeon 8060S à quarante unités de calcul et une mémoire LPDDR5x sur bus 256 bits. AMD annonce jusqu’à 128 Go de mémoire système et une enveloppe configurable de 45 à 120 W. Dans un mini-PC, cette intégration remplace l’ensemble processeur, carte graphique et VRAM séparée.
Son avantage distinctif est la mémoire unifiée. AMD indique que jusqu’à 96 Go peuvent être convertis en mémoire graphique sur une configuration 128 Go. Un modèle quantifié qui dépasse 32 Go peut donc rester largement chargé côté GPU, alors qu’une GeForce grand public doit le répartir entre sa VRAM et la RAM du système.
Cette capacité intéresse particulièrement les modèles 70B, les grands contextes et certains workflows génératifs lourds. Elle ne transforme pas la Radeon 8060S en RTX 5090. La bande passante annoncée pour la plateforme de développement AMD est de 256 Go/s, très loin des 1 792 Go/s publiés pour la RTX 5090. La comparaison pertinente oppose donc capacité accessible et débit, pas seulement deux nombres de mémoire.
La contrepartie est une configuration figée. La LPDDR5x est soudée et doit être choisie dès l’achat. Un modèle 64 Go ne deviendra pas 128 Go plus tard. Il faut également vérifier que le BIOS, le système et le moteur permettent d’affecter la quantité souhaitée à l’iGPU.
NVIDIA pour la vitesse
Les GeForce RTX bénéficient d’une VRAM dédiée à forte bande passante et d’un écosystème CUDA devenu la voie prioritaire de nombreux logiciels d’IA. Ollama prend officiellement en charge les séries RTX 40 et RTX 50. Quand le modèle tient entièrement dans la VRAM, cette combinaison simplifie généralement l’installation et offre un excellent débit.
La limite est la capacité. NVIDIA publie 12 Go pour la RTX 5070, 16 Go pour les RTX 5070 Ti et 5080, et 32 Go pour la RTX 5090. Ces valeurs conviennent à beaucoup de modèles 8B, 14B ou 32B quantifiés, mais un 70B Q4 d’environ 40 à 43 Go ne tient pas entièrement dans une seule GeForce 5090.
Le moteur peut décharger une partie du modèle vers la RAM et le CPU. L’exécution reste possible, mais la circulation des données entre les deux espaces réduit l’avantage de la carte. Une station professionnelle avec plus de VRAM ou plusieurs GPU résout ce problème à un autre niveau de prix, de volume et de consommation.
NVIDIA conserve aussi l’avantage pour les applications qui exigent explicitement CUDA, certaines bibliothèques de génération d’image et les projets dont la documentation suppose une GeForce. Un matériel théoriquement puissant perd de son intérêt si le logiciel choisi n’exploite pas son backend.
Logiciels et pilotes
Ollama documente CUDA pour NVIDIA, ROCm pour certains GPU AMD et un backend Vulkan encore expérimental. Sous Linux, la prise en charge AMD dépend de la distribution, du pilote et des droits d’accès au périphérique. Sous Windows, l’évolution de ROCm et des pilotes améliore progressivement la situation, mais chaque version doit être vérifiée.
Le projet llama.cpp prend en charge CUDA, HIP pour AMD et Vulkan. Sa matrice de fonctions montre que les backends ne sont pas parfaitement équivalents pour toutes les quantifications et opérations. Un résultat de benchmark n’est donc valable qu’avec le modèle, la version, le backend et les paramètres indiqués.
La voie NVIDIA est généralement plus prévisible : de nombreux guides, conteneurs et applications testent CUDA en premier. Strix Halo demande parfois davantage de réglages, mais sa grande mémoire devient inaccessible à NVIDIA si le logiciel ne sait pas répartir efficacement un modèle hors VRAM. Le bon outil doit donc être choisi avant le matériel.
Pour Ollama, contrôlez le chargement avec ollama ps. Pour llama.cpp, notez le backend et le nombre de couches déchargées vers le GPU. Une comparaison où le PC NVIDIA exécute tout en CUDA et le mini-PC AMD retombe partiellement sur CPU ne mesure pas seulement le matériel : elle mesure aussi la maturité du chemin logiciel.
Compacité et consommation
Strix Halo permet de concentrer CPU, GPU et mémoire dans un boîtier très réduit. La plateforme de développement AMD tient dans un volume de 150 × 150 × 45,4 mm avec une enveloppe annoncée à 120 W. Les mini-PC commerciaux peuvent adopter d’autres limites, mais l’intégration reste leur avantage structurel.
Un PC NVIDIA doit accueillir la carte, une alimentation plus puissante et un refroidissement séparé. Même un boîtier compact dépasse souvent le volume d’un mini-PC. En échange, chaque composant dispose de plus d’espace thermique et peut maintenir une puissance supérieure sur une charge longue.
La consommation ne se résume pas au TDP du processeur ou de la carte. Il faut mesurer la machine complète à la prise, au repos et pendant une génération prolongée. Un mini-PC qui ralentit pour rester silencieux peut produire moins de tokens par watt sur votre modèle qu’une tour bien refroidie. Sans protocole identique, aucune valeur isolée ne suffit.
Prix et évolutivité
Nous évitons un prix fixe car les configurations et promotions changent vite. Pour comparer correctement, additionnez la machine complète : mémoire, SSD, carte graphique, alimentation, boîtier et système de refroidissement. Un mini-PC Strix Halo 128 Go inclut d’emblée une mémoire coûteuse ; un PC NVIDIA peut être assemblé progressivement.
La GeForce est remplaçable. Vous pouvez commencer avec 16 Go de VRAM, puis changer de carte si les besoins augmentent. Le PC accepte souvent plus de stockage et de RAM système. Cette évolutivité prolonge la durée de vie, mais ne garantit pas qu’une future carte conservera la même alimentation ou le même encombrement.
Sur Strix Halo, le choix de 64 ou 128 Go est définitif. L’avantage est une plateforme cohérente, compacte et prête à l’emploi ; le risque est de sous-dimensionner la mémoire ou de payer une capacité jamais utilisée. Notre comparatif 64 Go face à 128 Go fournit les seuils avant la commande.
Quel système pour votre profil
Pour un assistant, du code et du RAG en 8B à 32B, un PC NVIDIA équipé de suffisamment de VRAM reste notre choix le plus simple. Le débit et la compatibilité priment, tandis que la capacité extrême de Strix Halo est peu sollicitée.
Pour un 70B quantifié dans un bureau compact, Strix Halo 128 Go devient très convaincant. La grande mémoire unifiée évite de répartir la majorité du modèle entre une petite VRAM et le CPU. Il faut accepter un débit dépendant du backend et une mémoire non extensible.
Pour la génération d’images et les outils CUDA, NVIDIA conserve l’avantage pratique. Vérifiez la VRAM nécessaire au workflow exact ; une RTX rapide mais trop juste peut échouer sur une grande résolution ou plusieurs modèles chargés.
Pour un laboratoire évolutif, la tour NVIDIA offre davantage de possibilités : carte remplaçable, plusieurs SSD, plus de RAM et parfois plusieurs GPU. Elle prend plus de place et demande une alimentation supérieure, mais évite de remplacer toute la machine lors du prochain saut matériel.
Notre conclusion n’est donc pas « AMD ou NVIDIA » en général. Choisissez Strix Halo lorsque la capacité unifiée et la compacité résolvent votre contrainte principale. Choisissez NVIDIA lorsque le modèle tient dans la VRAM et que vous voulez le chemin logiciel le plus direct.
Voir la fiche de configuration Ollama complète
Sources
Les caractéristiques ont été vérifiées le 24 août 2026 dans les spécifications AMD du Ryzen AI Max+ 395, le comparateur officiel des GeForce et la documentation matérielle Ollama. Aucun benchmark physique interne n’est revendiqué.